
Zu serverseitigem Tracking kursieren viele Meinungen: Ihre Agentur behauptet, der Umstieg löse das Einwilligungsproblem. Die Seite eines Tagging-Anbieters suggeriert dasselbe. Wir arbeiten im Bereich Compliance und schaffen hier Klarheit.
Kurz gesagt
Serverseitiges Tracking lässt sich mit der Datenschutz-Grundverordnung (DSGVO) vereinbaren. Wichtig ist dabei: Das ist nicht automatisch der Fall, und der Umstieg auf serverseitiges Tracking hebt Ihre Pflicht zur Einwilligung nicht auf. Die meiste Verwirrung rund um serverseitiges Tracking und die DSGVO entsteht durch eine falsche Annahme: dass die Regel den Daten folgt. Tatsächlich folgt sie dem Endgerät.
In diesem Artikel
Ist serverseitiges Tracking DSGVO-konform?
Serverseitiges Tracking ist nur dann DSGVO-konform, wenn das gesamte Setup die Anforderungen der Verordnung erfüllt – nicht schon durch die Architektur an sich. Der Umzug auf einen Server ändert, wo die Daten verarbeitet werden. Er ändert nichts daran, ob Sie eine Rechtsgrundlage für die Verarbeitung benötigen oder ob Sie überhaupt eine Einwilligung zum Auslesen des Endgeräts eines Besuchers brauchen. Sie erfassen und nutzen weiterhin Nutzerdaten – nur an einer anderen Stelle.
Client-seitig oder serverseitig ist eine Architekturentscheidung. Einwilligung und Rechtsgrundlage sind Pflichten, die sich daran knüpfen, was Sie auf dem Endgerät eines Besuchers tun (etwa Cookies setzen), und an die personenbezogenen Daten, die Sie anschließend verarbeiten. Eine pauschale Antwort für serverseitiges Tracking als solches gibt es deshalb nicht.
Was sich durch serverseitiges Tracking ändert – und was nicht
Bei serverseitigem Tracking sendet der Browser Events zunächst an einen Tracking-Server. Dieser verarbeitet sie und leitet die benötigten Daten an Ziele wie Google Analytics 4 oder die Meta Conversions API weiter – statt dass der Browser jeden Anbieter direkt aufruft.
Mehr erfahren
Wenn Sie die clientseitigen Grundlagen brauchen, starten Sie mit wie Website-Tracking funktioniert.
| Serverseitiges Tracking: was sich ändert | Was gegenüber clientseitigem Tracking gleich bleibt |
|---|---|
| Wo die Daten verarbeitet werden: auf einem von Ihnen konfigurierten Tracking-Server, nicht im Browser jedes Besuchers | Die Notwendigkeit einer Rechtsgrundlage nach Artikel 6 der DSGVO |
| Wer entscheidet, was Ihre Website verlässt: Ihre Container-Regeln, nicht das Skript jedes Anbieters | Die Notwendigkeit einer Einwilligung, bevor irgendetwas auf einem Gerät liest oder schreibt |
| Cookie-Lebensdauer und First-Party-Beständigkeit dank der First-Party-Subdomain | Was die ePrivacy-Richtlinie für diesen ersten Lese- oder Schreibvorgang verlangt, unabhängig davon, ob es sich um Third-Party-Cookies handelt oder nicht |
| Wie viele Dritte den Browser erreichen, und welche Felder Sie vorher entfernen | Ihre Transparenzpflichten: Jeder Empfänger gehört in Ihre Richtlinien |
Wie funktioniert serverseitiges Tracking?
Vier Schritte:
- Der Browser des Besuchers sendet ein Event an eine First-Party-Subdomain wie
analytics.yourdomain.com. - Der Tracking-Server empfängt es.
- Der Server wendet Ihre Regeln für Filterung und Anreicherung an.
- Der Server leitet das Verbleibende an die verbundenen Ziele weiter.
Mehr erfahren
Unser Leitfaden zu serverseitigem Tracking geht ausführlich auf jeden Schritt und die dahinterliegende Einrichtung ein.
Warum serverseitiges Tracking die Einwilligungspflicht nicht aufhebt
Maßgeblich ist das Endgerät, nicht das Ziel der Daten
Dass die Behauptung „Serverseitig braucht man keine Einwilligung“ nicht stimmt, hat wenig mit der DSGVO zu tun. Der Grund liegt in der EU-ePrivacy-Richtlinie, dem Gesetz hinter den Cookie-Bannern.
Die ePrivacy-Richtlinie wirkt über nationales Recht, verbindlich ist also die jeweilige nationale Umsetzung – etwa Artikel 122 des italienischen Datenschutzgesetzes, die PECR in Großbritannien oder das TDDDG in Deutschland. Die Regel ist überall dieselbe. Die Details und die zuständige Aufsichtsbehörde sind es nicht.
Artikel 5(3) verlangt, dass das Speichern von Informationen im Endgerät eines Nutzers oder der Zugriff auf bereits gespeicherte Informationen nur mit dessen Einwilligung erfolgen darf – nach klarer und umfassender Information über die Zwecke. Zwei enge Ausnahmen gelten: die Durchführung der Übertragung einer Nachricht und das, was zwingend erforderlich ist, damit ein Anbieter einen vom Nutzer ausdrücklich angeforderten Onlinedienst bereitstellen kann.
Bemerkenswert: Die Vorschrift erwähnt an keiner Stelle, wohin die Informationen anschließend gelangen. Die Pflicht knüpft an den Moment an, in dem etwas vom Gerät liest oder darauf schreibt.
Der Europäische Datenschutzausschuss (EDSA) hat sich dazu direkt in seinen Leitlinien 2/2023 zum technischen Anwendungsbereich von Artikel 5(3) geäußert. Der EDSA bestätigt, dass Artikel 5(3) auch dann gilt, wenn die Stelle, die die Informationen empfängt, nicht dieselbe ist, die das Gerät zur Übermittlung veranlasst hat. Anders gesagt: Es macht keinen Unterschied, ob ein Tracking-Server oder eine Werbeplattform die Daten empfängt.
Die Leitlinien gehen noch weiter: Auch die Anweisung an einen Browser, Informationen zurückzusenden, gilt als Zugriff – ob über Cookies, JavaScript oder einen API-Aufruf. Dieselbe Schlussfolgerung gilt für Informationen, die lokal auf dem Gerät verarbeitet und anschließend an einen Server gesendet werden.
Auch eine spätere Anonymisierung ändert daran nichts. Im Fall Planet49 entschied der Europäische Gerichtshof, dass der Schutz jede im Endgerät gespeicherte Information erfasst – unabhängig davon, ob es sich um personenbezogene Daten handelt.
Was die DSGVO für weitergeleitete Daten vorschreibt
Zwei Pflichten laufen parallel: Die ePrivacy-Richtlinie regelt den Zugriff auf das Gerät, die DSGVO regelt, was anschließend mit den personenbezogenen Daten passiert.
- Artikel 6(1) verlangt eine Rechtsgrundlage für die Verarbeitung personenbezogener Daten. Ist diese Grundlage die Einwilligung, muss der Besucher der Verarbeitung für einen oder mehrere festgelegte Zwecke zugestimmt haben. Berechtigte Interessen nach Artikel 6(1)(f) sind eine Alternative, tragen aber bei der Weiterleitung von Daten an Werbeplattformen selten so weit, wie Teams sich das erhoffen – denn die Einwilligungspflicht aus der ePrivacy-Richtlinie greift bereits vorher.
Mehr erfahren
Unsere Übersicht zu den Anforderungen der DSGVO deckt alle wichtigen Punkte ab.
- Artikel 7(1) verlangt, dass der Verantwortliche nachweisen kann, dass der Besucher eingewilligt hat. Sie brauchen also einen Nachweis, den Sie tatsächlich vorlegen können – nicht nur die Annahme, dass ein Banner seine Aufgabe erfüllt hat.
- Artikel 7(3) verlangt, dass der Widerruf einer Einwilligung genauso einfach ist wie ihre Erteilung – ein Widerruf muss also den Container erreichen und die Weiterleitung stoppen.
Personenbezogene Daten, die einen Tracking-Server durchlaufen, bleiben personenbezogene Daten und unterliegen weiterhin allen oben genannten Anforderungen.
Wie DSGVO und ePrivacy-Richtlinie Marketing-Messung einordnen
Messung ist der einzige Bereich, in dem überhaupt eine Ausnahme greift. Manche Aufsichtsbehörden behandeln reine Reichweitenmessung anders als Marketing-Analytics. Die französische CNIL etwa nimmt Tracker zur Reichweitenmessung aus, die ausschließlich diesem Zweck dienen, allein im Auftrag des Publishers arbeiten, anonyme Statistiken erzeugen und Grenzen für Lebensdauer und Speicherung einhalten. Die Ausnahme ist eng gefasst und unterscheidet sich zwischen den Mitgliedstaaten.
Alles andere, was Marketer einsetzen, fällt nicht darunter: Retargeting, Conversion-Tracking, Lookalike-Audiences, Cross-Device-Attribution. Dafür braucht der Gerätezugriff eine Einwilligung und die Verarbeitung eine Rechtsgrundlage – unabhängig davon, ob die Anfrage vom Browser oder vom Server ausgeht.
Wie das Einwilligungssignal den Tracking-Server erreicht
Zu wissen, dass eine Einwilligung nötig ist, ist der leichte Teil. In einem serverseitigen Setup muss dieses Signal einen längeren Weg zurücklegen als clientseitig.
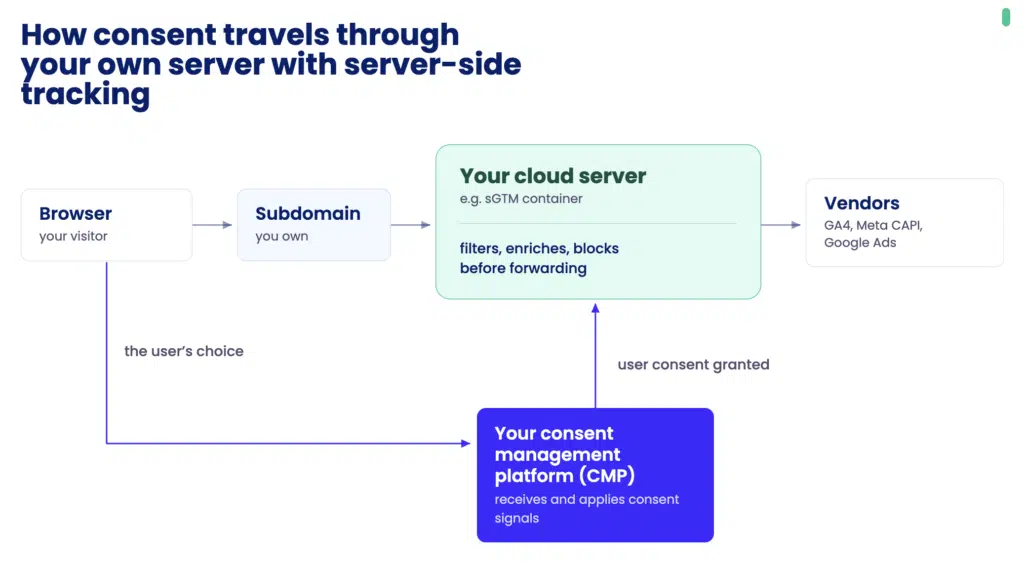
Die Kette ist kurz: Ihre Consent-Management-Plattform (CMP) erfasst die Entscheidung des Besuchers im Browser, diese Entscheidung reist mit jedem Event zum Tracking-Server, und der Container entscheidet pro Ziel, ob er weiterleitet, kürzt oder verwirft.
Bei Google-Zielen übernimmt das Google Consent Mode diese Aufgabe. Googles serverseitige Dokumentation beschreibt den Mechanismus unmissverständlich: Das Google-Tag übergibt den Einwilligungsstatus des Besuchers zusammen mit dem Event an den Server-Container, und Googles Produkt-Tags im Server passen daraufhin an, was sie senden. Ebenso klar äußert sich Google dazu, wer für den ersten Schritt verantwortlich ist: „Sie sind dafür verantwortlich, die Einwilligung der Nutzer auf Ihrer Website oder App einzuholen.“ Die meisten CMPs haben Consent Mode bereits integriert.
Das heißt: Ihr Einwilligungs-Setup muss zuverlässig funktionieren. Ein Container, der kein Einwilligungssignal erhält, wird dadurch nicht automatisch von der Pflicht ausgenommen – er leitet weiterhin Daten weiter, und die Dashboards füllen sich unverändert. Am schwierigsten ist der erste Besuch, da die Entscheidung des Besuchers bei der ersten Interaktion noch nicht bekannt ist. Starten Sie mit einer CMP, die Einwilligungen zuverlässig erfasst und speichert, und stellen Sie dann sicher, dass die Serverseite dieses Signal empfängt und danach handelt.
Wirkt sich serverseitiges Tracking auf die Compliance aus?
Serverseitiges Tracking wirkt sich tatsächlich auf Ihre Compliance aus – und richtig umgesetzt, ist dieser Effekt positiv. Nichts von dem oben Genannten macht es zur schlechteren Wahl für den Datenschutz. Im Gegenteil: Es lässt sich als datenschutzfreundlichere Tracking-Methode betrachten:
- Sie setzen Ihre Regeln auf Infrastrukturebene durch, an einer einzigen Stelle, die Sie selbst kontrollieren – statt sich darauf zu verlassen, dass jedes Anbieter-Skript sie einhält.
- Sie entscheiden, wo der Tracking-Server läuft – ein EU-Hosting hält den ersten Verarbeitungsschritt innerhalb der EU. Übermittlungen an Ziele außerhalb des EWR benötigen weiterhin eine Grundlage nach Kapitel V der DSGVO.
- Sie legen fest, welche Felder Ihre Website verlassen, und können Identifikatoren entfernen oder sie hashen, wo das nicht möglich ist. Hashing verringert das Risiko, aber eine gehashte E-Mail-Adresse oder Telefonnummer bleibt personenbezogene Daten – dieselben Pflichten gelten also weiterhin.
- Weniger Anbieter erreichen den Browser direkt – dadurch lesen weniger unabhängige Dritte das Endgerät jedes Besuchers, und weniger Skripte sind überhaupt in der Lage, Informationen zu erfassen, für die sie nie autorisiert waren.
- Jeder Durchlauf über den Server lässt sich protokollieren, sodass Sie zeigen können, was weitergeleitet wurde und warum. Das ist ein Nachweis der Durchsetzung: Er ergänzt Ihre Einwilligungsnachweise nach Artikel 7(1), ersetzt sie aber nicht.
Die stärksten Setups schließen den Kreis mit ihrer Consent-Management-Plattform: Jedes Event wird vor der Weiterleitung gegen die Entscheidung des Besuchers geprüft, einmal gezählt und von diesem einen verifizierten Datensatz aus an jede nachgeschaltete Plattform gesendet.
Wie ein DSGVO-konformes serverseitiges Setup aussieht
Zu wissen, wie man serverseitiges Tracking einrichtet, ist eine Sache. So gelingt die Einrichtung, ohne dass die Compliance darunter leidet.
- Bestimmen Sie die Rechtsgrundlage für jedes Ziel einzeln. Ein Container kann sechs Empfänger versorgen, und die stützen sich nicht unbedingt alle auf dieselbe Grundlage.
- Holen Sie die Einwilligung vor jedem Gerätezugriff ein, nicht erst vor der Weiterleitung. Auslöser ist das Lesen oder Schreiben durch den Browser – bevor Ihr Server überhaupt etwas erfährt.
- Übergeben Sie den Einwilligungsstatus bei jedem Event an den Container. Ein Container, der die Entscheidung nicht sieht, kann nicht danach handeln.
- Entfernen Sie Identifikatoren vor der Weiterleitung, wo immer möglich, etwa E-Mail-Adressen und Telefonnummern, und hashen Sie sie, wo das nicht geht. Hashing ist Minimierung, keine Anonymisierung: gehashte Identifikatoren bleiben personenbezogene Daten und fallen weiterhin in den Anwendungsbereich. Machen Sie Datenminimierung zum Standard.
- Wählen Sie das Hosting mit Blick auf Datenübermittlungen. EU-Hosting verringert das Risiko am Container, aber jedes Ziel außerhalb des EWR braucht weiterhin eine eigene Übermittlungsgrundlage.
- Dokumentieren Sie jedes Ziel in Ihrer Datenschutz- und Cookie-Richtlinie. Ein Empfänger, der nicht in der Richtlinie steht, ist ein nicht offengelegter Empfänger.
- Prüfen Sie, was den Container verlässt, und prüfen Sie es nach jeder Tag-Änderung erneut. Kontrollieren Sie die ausgehende Payload, statt sich auf die Konfiguration allein zu verlassen.
Was das für Sie bedeutet
Die letzte Frage, die Sie beantworten müssen: Erfüllt Ihr konkretes Setup die für Sie geltenden regulatorischen Anforderungen – also Einwilligung einholen, eine Rechtsgrundlage haben und Ihre Aktivitäten in Ihren Richtlinien offenlegen?
Die stärksten Setups behandeln Messung und Einwilligung nicht länger als zwei getrennte Systeme. Genau das ist der Gedanke hinter unserer Lösung für serverseitiges Tracking: Tracking-Pipeline und Einwilligungsebene als ein System – statt zwei, die Sie selbst mühsam verbinden müssen.
Events werden vor der Weiterleitung gegen die Entscheidung des Besuchers geprüft, und die Standardkonfiguration blockiert alles ohne gültige Einwilligung.
FAQ
Brauche ich weiterhin ein Cookie-Banner, wenn ich serverseitiges Tracking nutze?
Ja, Sie brauchen weiterhin ein Cookie-Banner, wenn Sie serverseitiges Tracking einsetzen – in jedem Setup, in dem etwas für nicht ausgenommene Zwecke vom Endgerät eines Besuchers liest oder darauf schreibt. Die ePrivacy-Richtlinie knüpft die Einwilligungspflicht an genau diesen Gerätezugriff, und ein serverseitiger Container ist diesem Zugriff nachgeschaltet.
Ist einwilligungsfreies Ad-Tracking serverseitig möglich?
Nein, einwilligungsfreies Ad-Tracking ist auch serverseitig nicht möglich. Werbung und Cross-Site-Messung fallen nicht unter die Ausnahmen der ePrivacy-Richtlinie, die nur die Übertragung und das für die Bereitstellung eines vom Nutzer ausdrücklich angeforderten Onlinedienstes zwingend Erforderliche abdecken. Der EDSA hat bestätigt, dass Artikel 5(3) unabhängig davon gilt, welche Stelle die Daten empfängt – das Leiten von Events über einen Tracking-Server schafft also keine Ausnahme, die clientseitig nicht ebenfalls gelten würde.
Ist serverseitiges Tracking besser für den Datenschutz als clientseitiges Tracking?
Serverseitiges Tracking kann datenschutzfreundlicher sein als clientseitiges – automatisch ist das aber nicht. Es schafft einen zentralen Kontrollpunkt, an dem Sie Identifikatoren entfernen, festlegen können, welche Anbieter Daten erhalten, und bestimmen, wo die Verarbeitung stattfindet. Das ist einer Situation vorzuziehen, in der jedes Anbieter-Skript direkt mit dem Browser kommuniziert.