
Probabilmente hai già sentito diverse opinioni sul server-side tracking: la tua agenzia dice che passare al server-side risolve il problema del consenso, e la pagina di un fornitore di tag manager suggerisce lo stesso. Noi lavoriamo nella conformità, e siamo qui per fare un po’ di chiarezza.
In breve
Il server-side tracking può essere conforme al Regolamento generale sulla protezione dei dati (GDPR). Va però chiarito che non lo è di default: passare il tracciamento al server non elimina l’obbligo di raccogliere il consenso. Gran parte della confusione tra server-side tracking e GDPR nasce da un’unica assunzione, cioè che la regola segua i dati. In realtà, la regola segue il dispositivo.
In questo articolo
Il server-side tracking è conforme al GDPR?
Il server-side tracking è conforme al GDPR solo se il setup nel suo complesso rispetta i requisiti del regolamento, non per merito dell’architettura in sé. Spostare il tracciamento su un server cambia dove i dati vengono elaborati, ma non cambia la necessità di una base giuridica per trattarli, né l’obbligo di consenso per leggere il dispositivo di un visitatore. Continui a raccogliere e utilizzare dati degli utenti: solo altrove.
Client-side o server-side è una scelta architetturale. Consenso e base giuridica sono obblighi legati a ciò che fai sul dispositivo del visitatore, come installare cookie, e ai dati personali che tratti in seguito. Per il server-side tracking in sé, quindi, non esiste una risposta univoca.
Cosa cambia con il server-side tracking, e cosa no
Con il server-side tracking, gli eventi vengono inviati dal browser a un tracking server, che li elabora e inoltra ciò che serve a destinazioni come Google Analytics 4 o la Meta Conversions API, invece di far chiamare ogni vendor direttamente dal browser.
Scopri di più
Se ti serve prima la base del client-side, parti da come funziona il tracciamento dei siti web.
| Server-side tracking: cosa cambia | Cosa resta uguale rispetto al client-side tracking |
|---|---|
| Dove vengono elaborati i dati: su un tracking server che configuri tu, non nel browser di ogni visitatore | La necessità di una base giuridica ai sensi dell’articolo 6 del GDPR |
| Chi decide cosa esce dal tuo sito: le regole del tuo container, non lo script di ogni vendor | La necessità del consenso prima che qualcosa legga o scriva sul dispositivo |
| La durata dei cookie e la persistenza first-party, grazie al sottodominio first-party | Cosa richiede la direttiva ePrivacy per quella prima lettura o scrittura, che si tratti di cookie di terze parti o no |
| Quante terze parti raggiungono il browser, e quali campi elimini prima che lo facciano | I tuoi obblighi di trasparenza: ogni destinatario deve figurare nelle tue policy |
Come funziona il server-side tracking?
Quattro passaggi:
- Il browser del visitatore invia un evento a un sottodominio first-party come
analytics.yourdomain.com. - Il tracking server lo riceve.
- Il server applica le tue regole di filtraggio e arricchimento dei dati.
- Il server inoltra ciò che resta alle destinazioni che hai collegato.
Scopri di più
La nostra guida al server-side tracking approfondisce ogni passaggio e il lavoro di configurazione che c’è dietro.
Perché passare al server-side non elimina la necessità del consenso
L’obbligo riguarda il dispositivo, non la destinazione
Il motivo per cui l’idea che «il server-side eviti il consenso» non tiene ha poco a che fare con il GDPR. La ragione sta nella direttiva ePrivacy dell’UE, la norma dietro ai cookie banner.
La direttiva ePrivacy si applica attraverso le leggi nazionali: il testo che ti vincola davvero è quindi il recepimento nel tuo paese, ad esempio l’articolo 122 del Codice Privacy italiano, il PECR nel Regno Unito o il TDDDG in Germania. La regola è la stessa ovunque; i dettagli, e l’autorità che li fa rispettare, no.
L’articolo 5(3) stabilisce che l’archiviazione di informazioni, o l’accesso a informazioni già archiviate, nel dispositivo terminale di un utente può avvenire solo con il suo consenso, dopo un’informativa chiara e completa sulle finalità. Sono previste due eccezioni ristrette: l’esecuzione della trasmissione di una comunicazione e quanto strettamente necessario al fornitore per erogare un servizio online esplicitamente richiesto dall’utente.
Nota cosa la norma non menziona mai: dove viaggiano le informazioni in seguito. L’obbligo riguarda il momento in cui qualcosa legge dal dispositivo o vi scrive.
Il Comitato europeo per la protezione dei dati (EDPB) ha affrontato la questione direttamente nelle sue Linee guida 2/2023 sull’ambito tecnico dell’articolo 5(3), confermando che l’articolo può applicarsi anche quando chi riceve le informazioni non è chi ha istruito il dispositivo a inviarle. In altre parole, non fa differenza se i dati arrivano a un tracking server o a una piattaforma pubblicitaria.
Le linee guida vanno oltre: l’accesso comprende anche l’istruire un browser a rimandare informazioni, tramite cookie, JavaScript o una chiamata API, e la stessa conclusione vale per le informazioni elaborate localmente sul dispositivo e poi inviate a un server.
Anche l’anonimizzazione a valle non risolve la questione: nel caso Planet49, la Corte di giustizia dell’UE ha stabilito che la tutela riguarda qualsiasi informazione archiviata nel dispositivo terminale, indipendentemente dal fatto che sia dato personale.
Cosa richiede il GDPR per i dati che inoltri
Due obblighi corrono in parallelo: la direttiva ePrivacy disciplina l’accesso al dispositivo, il GDPR disciplina cosa succede ai dati personali in seguito.
- L’articolo 6(1) richiede una base giuridica per il trattamento dei dati personali. Quando quella base è il consenso, deve trattarsi del consenso del visitatore al trattamento per una o più finalità specifiche. Il legittimo interesse ai sensi dell’articolo 6(1)(f) esiste come alternativa, ma quando si tratta di inoltrare dati a piattaforme pubblicitarie raramente ha il peso che i team sperano, perché il requisito di consenso dell’ePrivacy si applica a monte.
Scopri di più
La nostra guida ai requisiti di conformità al GDPR approfondisce l’argomento nel dettaglio.
- L’articolo 7(1) richiede che il titolare del trattamento sia in grado di dimostrare che il visitatore ha dato il consenso: ti serve quindi una prova che puoi effettivamente produrre, non la presunzione che il banner abbia fatto il suo lavoro.
- L’articolo 7(3) richiede che revocare il consenso sia facile quanto darlo: una revoca deve quindi arrivare al container e interrompere l’inoltro.
I dati personali che passano attraverso un tracking server restano dati personali e restano soggetti a tutti i requisiti visti finora.
La misurazione marketing nel GDPR e nella direttiva ePrivacy
La misurazione è l’unico ambito in cui esiste una qualche esenzione. Alcune autorità trattano la pura misurazione dell’audience in modo diverso dall’analisi di marketing. La CNIL francese, ad esempio, esenta gli strumenti di tracciamento per la misurazione dell’audience che servono solo a quello scopo, operano per conto esclusivo dell’editore, producono statistiche anonime e rispettano i limiti su durata e conservazione. È un’eccezione ristretta, e varia da stato membro a stato membro.
Tutto il resto di ciò che i marketer utilizzano ne resta fuori: retargeting, conversion tracking, lookalike audience, attribuzione cross-device. In questi casi l’accesso al dispositivo richiede il consenso e il trattamento richiede una base giuridica, sia che la richiesta parta da un browser sia che parta da un server.
Come il segnale di consenso arriva al tracking server
Sapere che il consenso è necessario è la parte facile. In un setup server-side, quel segnale deve percorrere una strada più lunga rispetto al client-side.
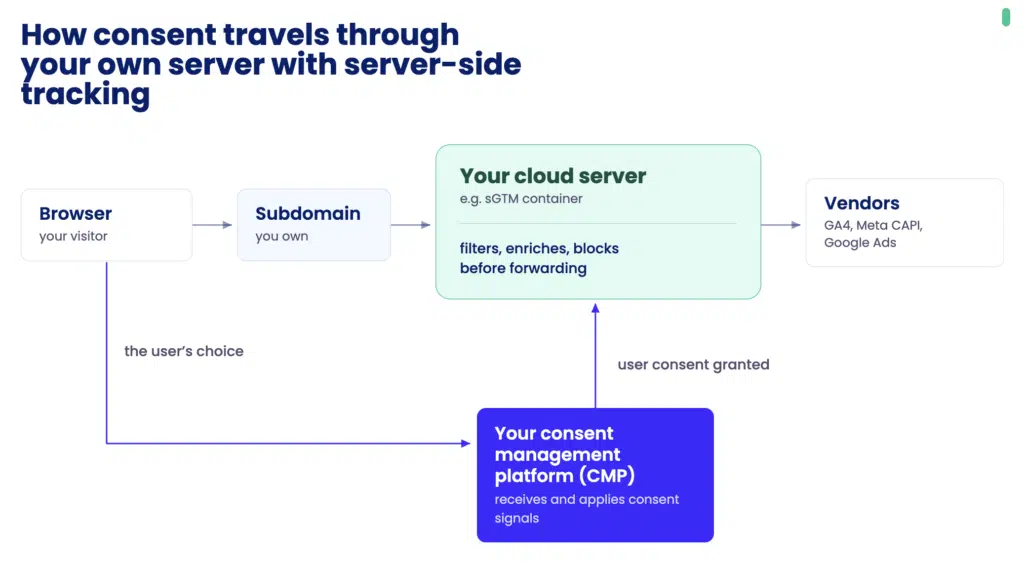
La catena è breve: la tua consent management platform (CMP) raccoglie la scelta del visitatore nel browser, la scelta viaggia insieme a ogni evento verso il tracking server, e il container decide per ogni destinazione se inoltrare, filtrare o scartare i dati.
Per le destinazioni Google, a occuparsene è Google Consent Mode. La documentazione server-side di Google descrive il meccanismo con chiarezza: il tag Google trasmette lo stato di consenso del visitatore al container server insieme all’evento, e i tag prodotto di Google nel server adattano di conseguenza cosa inviano. Google è altrettanto chiaro su chi possiede il primo passaggio: «Sei responsabile di ottenere il consenso degli utenti sul tuo sito web o app». La maggior parte delle CMP integra già Consent Mode.
Questo significa che devi assicurarti che il tuo setup di consenso sia solido. Un container che non riceve nessun segnale di consenso non diventa esente: continua a inoltrare, e le dashboard continuano a riempirsi. Il caso più critico è la prima visita, perché la scelta del visitatore non è ancora nota alla prima interazione. Parti da una CMP che raccoglie e conserva il consenso in modo affidabile, poi verifica che il server lo riceva e agisca di conseguenza.
Il server-side tracking ha un impatto sulla conformità?
Il server-side tracking ha un impatto sulla tua conformità, e se gestito bene l’effetto è positivo. Niente di quanto visto lo rende una scelta peggiore per la privacy: anzi, può essere considerato un metodo di tracciamento più attento alla privacy:
- Applichi le tue regole a livello di infrastruttura, in un unico punto che controlli, invece di dipendere dallo script di ogni vendor per farle rispettare.
- Scegli dove far girare il tracking server, quindi un setup ospitato nell’UE mantiene il primo passaggio di elaborazione in UE. I trasferimenti verso destinazioni fuori dal SEE devono comunque seguire la relativa base giuridica prevista dal Capo V del GDPR.
- Controlli quali campi escono dal tuo sito, così puoi eliminare gli identificatori o, dove non puoi, sottoporli a hashing. L’hashing riduce l’esposizione, ma un’email o un numero di telefono sottoposti a hashing restano dati personali, quindi gli stessi obblighi si applicano anche a loro.
- Meno vendor raggiungono direttamente il browser, quindi meno soggetti indipendenti leggono il dispositivo di ogni visitatore, e meno script si trovano nella posizione di raccogliere informazioni che non erano mai stati autorizzati a raccogliere.
- Ogni flusso che passa dal server può essere registrato, così puoi dimostrare cosa è stato inoltrato e perché. È una prova di applicazione delle regole: si affianca ai tuoi registri di consenso previsti dall’articolo 7(1), ma non li sostituisce.
I setup più solidi chiudono il cerchio con la propria consent management platform: ogni evento viene verificato rispetto alla scelta del visitatore prima di muoversi, viene conteggiato una sola volta e inviato a tutte le piattaforme a valle a partire da quell’unico record verificato.
Come deve essere una configurazione server-side conforme
Sapere come configurare il server-side tracking è una cosa. Ecco come farlo in modo che anche la conformità tenga.
- Individua la base giuridica per ogni destinazione, separatamente. Un container può alimentare sei destinatari, e non è garantito che si basino tutti sulla stessa base giuridica.
- Raccogli il consenso prima di qualsiasi accesso al dispositivo, non solo prima dell’inoltro. Il momento che conta è quando il browser legge o scrive, prima ancora che il tuo server ne sappia qualcosa.
- Trasmetti lo stato del consenso al container con ogni evento. Un container che non vede la scelta non può agire di conseguenza.
- Elimina gli identificatori prima dell’inoltro quando puoi, come indirizzi email e numeri di telefono, e sottoponili a hashing quando non puoi. L’hashing è minimizzazione, non anonimizzazione: gli identificatori sottoposti a hashing restano dati personali e restano nell’ambito di applicazione. Considera la minimizzazione dei dati come impostazione predefinita.
- Scegli l’hosting tenendo conto dell’esposizione legata ai trasferimenti. Un hosting nell’UE riduce l’esposizione a livello di container, ma ogni destinazione fuori dal SEE ha comunque bisogno di una propria base per il trasferimento.
- Documenta ogni destinazione nella tua privacy policy e cookie policy. Un destinatario che non è nella policy è un destinatario non dichiarato.
- Verifica cosa esce dal container, e verifica di nuovo dopo ogni modifica ai tag. Controlla il payload in uscita, invece di fidarti che la configurazione descriva da sola il proprio comportamento.
Cosa significa per te
La domanda finale a cui devi rispondere è se il tuo specifico setup fa quanto richiesto dalle normative che ti si applicano: raccogliere il consenso, avere una base giuridica e dichiarare le tue attività nelle policy.
I setup più solidi smettono di trattare misurazione e consenso come due sistemi separati. È l’idea alla base della nostra soluzione di server-side tracking: pipeline di tracciamento e livello di consenso come un unico sistema, invece di due che devi capire come collegare da solo.
Gli eventi vengono verificati rispetto alla scelta del visitatore prima di muoversi, e la configurazione predefinita blocca tutto ciò che non ha un consenso valido.
FAQ
Mi serve ancora un cookie banner se uso il server-side tracking?
Sì. Ti serve comunque un cookie banner se usi il server-side tracking, in qualsiasi setup in cui qualcosa legge dal dispositivo del visitatore o vi scrive per finalità non esenti. La direttiva ePrivacy lega l’obbligo di consenso a quell’accesso al dispositivo, e un container server-side si trova a valle di esso.
Il tracciamento pubblicitario senza consenso è possibile lato server?
No. Il tracciamento pubblicitario senza consenso non è possibile nemmeno lato server. Pubblicità e misurazione cross-site restano fuori dalle eccezioni della direttiva ePrivacy, che riguardano la trasmissione e la stretta necessità per il fornitore di erogare un servizio online esplicitamente richiesto dall’utente. L’EDPB ha confermato che l’articolo 5(3) si applica indipendentemente da chi riceve i dati: instradare gli eventi attraverso un tracking server non crea quindi nessuna eccezione che non esistesse già lato client.
Il server-side tracking è migliore per la privacy rispetto al client-side?
Il server-side tracking può essere più rispettoso della privacy rispetto al client-side, ma non lo è automaticamente. Ti offre un unico checkpoint in cui puoi rimuovere gli identificatori, limitare quali vendor ricevono i dati e controllare dove avviene l’elaborazione: una condizione migliore rispetto ad avere lo script di ogni vendor che parla direttamente con il browser.