
Seguramente has oído opiniones diferentes sobre el tracking del lado del servidor: tu agencia te dice que pasar al lado del servidor resuelve el problema del consentimiento, y la web de algún proveedor de tags da a entender lo mismo. Nosotros trabajamos en cumplimiento y estamos aquí para aclarar las cosas.
En resumen
El tracking del lado del servidor puede ajustarse al Reglamento General de Protección de Datos (RGPD). Aun así, es importante entender que no cumple la normativa por defecto, y pasar tu tracking al lado del servidor no elimina tu obligación de recabar el consentimiento. Buena parte de la confusión entre el tracking del lado del servidor y el RGPD viene de una idea equivocada: que la norma sigue a los datos. En realidad, la norma sigue al dispositivo.
En este artículo
¿El tracking del lado del servidor cumple con el RGPD?
El tracking del lado del servidor cumple el RGPD solo cuando la configuración que lo rodea satisface los requisitos de la normativa, no por la arquitectura en sí. Trasladar el tracking a un servidor cambia dónde se procesan los datos, pero no cambia si necesitas una base jurídica para tratarlos, ni si necesitas consentimiento para acceder al dispositivo del visitante. Sigues recopilando y usando datos de los usuarios. Solo que en otro lugar.
La elección entre el lado del cliente y el lado del servidor es una decisión de arquitectura. El consentimiento y la base jurídica son obligaciones que dependen de lo que haces en el dispositivo del visitante (como instalar cookies) y de los datos personales que tratas después. Por eso no existe una respuesta única y general para el tracking del lado del servidor.
Qué cambia con el tracking del lado del servidor, y qué no
En el tracking del lado del servidor, el navegador envía primero los eventos a un servidor de tracking, que los procesa y reenvía lo necesario a destinos como Google Analytics 4 o la API de conversiones de Meta, en lugar de que el navegador llame directamente a cada proveedor.
Leer más
Si necesitas repasar la base del tracking del lado del cliente, empieza por cómo funciona el tracking en páginas web.
| Tracking del lado del servidor: qué cambia | Qué se mantiene igual respecto al tracking del lado del cliente |
|---|---|
| Dónde se procesan los datos: en un servidor de tracking que tú configuras, no en el navegador de cada visitante | La necesidad de una base jurídica según el artículo 6 del RGPD |
| Quién decide qué sale de tu sitio: las reglas de tu contenedor, no el script de cada proveedor | La necesidad de consentimiento antes de que algo lea o escriba en un dispositivo |
| La vida de las cookies y su durabilidad como first-party, gracias al subdominio propio | Lo que exige la Directiva ePrivacy sobre esa primera lectura o escritura, sean cookies de terceros o no |
| Cuántos terceros llegan al navegador, y qué campos eliminas antes de que lo hagan | Tus obligaciones de transparencia: cada destinatario debe figurar en tus políticas |
¿Cómo funciona el tracking del lado del servidor?
Cuatro pasos:
- El navegador del visitante envía un evento a un subdominio propio, como
analytics.yourdomain.com. - El servidor de tracking lo recibe.
- El servidor aplica tus reglas de filtrado y enriquecimiento.
- El servidor reenvía lo que queda a los destinos que has conectado.
Leer más
Nuestra guía sobre el tracking del lado del servidor explica en detalle cada paso y el trabajo de configuración que hay detrás.
Por qué pasar al lado del servidor no elimina la necesidad de consentimiento
La obligación se vincula al dispositivo, no al destino
El motivo por el que la afirmación de que «el lado del servidor evita el consentimiento» no se sostiene tiene poco que ver con el RGPD. Está en la Directiva ePrivacy de la UE, la ley que hay detrás de los banners de cookies.
La Directiva ePrivacy se aplica a través de la legislación nacional, así que el texto que realmente te vincula es la trasposición de tu país: por ejemplo, el artículo 122 del Código de Privacidad italiano, la PECR en el Reino Unido o la TDDDG en Alemania. La norma es la misma en todas partes; el detalle, y la autoridad que la hace cumplir, no.
El artículo 5(3) exige que almacenar información, o acceder a información ya almacenada, en el equipo terminal de un usuario solo pueda hacerse con su consentimiento, tras haberle informado con claridad y de forma completa sobre las finalidades. Existen dos excepciones limitadas: la transmisión de una comunicación y lo que resulte estrictamente necesario para que un proveedor preste un servicio en línea que el usuario haya solicitado expresamente.
Fíjate en lo que la disposición no menciona en ningún momento: a dónde viaja la información después. La obligación se activa en el momento en que algo lee o escribe en el dispositivo.
El Comité Europeo de Protección de Datos (CEPD) abordó esto directamente en sus Directrices 2/2023 sobre el alcance técnico del artículo 5(3). El CEPD confirma que el artículo 5(3) puede aplicarse aunque la entidad que recibe la información no sea la que ordenó al dispositivo enviarla. En otras palabras, da igual que los datos los reciba un servidor de tracking o una plataforma publicitaria.
Las directrices van más allá: acceder a información incluye ordenar al navegador que la envíe de vuelta, ya sea mediante cookies, JavaScript o una llamada a una API, y la misma conclusión se aplica a la información que se procesa localmente en el dispositivo y luego se envía a un servidor.
Anonimizar los datos más adelante tampoco resuelve la cuestión. En el caso Planet49, el Tribunal de Justicia de la Unión Europea determinó que la protección cubre cualquier información almacenada en el equipo terminal, sea o no un dato personal.
Qué exige el RGPD sobre los datos que reenvías
Hay dos obligaciones que funcionan en paralelo: la Directiva ePrivacy regula el acceso al dispositivo, y el RGPD regula lo que ocurre después con los datos personales.
- El artículo 6(1) exige una base jurídica para tratar datos personales. Cuando esa base es el consentimiento, tiene que ser el consentimiento del visitante para el tratamiento con una o varias finalidades específicas. El interés legítimo del artículo 6(1)(f) existe como alternativa, pero a la hora de reenviar datos a plataformas publicitarias, rara vez tiene el peso que los equipos esperan, porque la exigencia de consentimiento de ePrivacy actúa antes, en un paso previo.
Leer más
Nuestra guía sobre los requisitos de cumplimiento del RGPD cubre todos los aspectos en detalle.
- El artículo 7(1) exige que el responsable del tratamiento pueda demostrar que el visitante dio su consentimiento, así que necesitas un registro que puedas presentar de verdad, no la suposición de que el banner hizo su trabajo.
- El artículo 7(3) exige que retirar el consentimiento sea tan fácil como darlo, así que esa retirada tiene que llegar al contenedor y detener el reenvío.
Los datos personales que pasan por un servidor de tracking siguen siendo datos personales, y están sujetos a todos los requisitos anteriores.
Dónde se sitúa la medición de marketing según el RGPD y la Directiva ePrivacy
La medición es la única área con alguna excepción. Algunos reguladores tratan la simple medición de audiencia de forma distinta a la analítica de marketing. La CNIL francesa, por ejemplo, exime a los rastreadores de medición de audiencia que sirven solo para ese fin, funcionan exclusivamente para el editor del sitio, generan estadísticas anónimas y respetan los límites de vida y conservación del rastreador. Es una excepción muy limitada, y varía entre los estados miembros.
Todo lo demás que hacen los equipos de marketing queda fuera de esa excepción: retargeting, seguimiento de conversiones, audiencias similares, atribución entre dispositivos. En estos casos, el acceso al dispositivo necesita consentimiento y el tratamiento necesita una base jurídica, tanto si la solicitud sale de un navegador como de un servidor.
Cómo llega la señal de consentimiento al servidor de tracking
Saber que se necesita consentimiento es la parte fácil. En una configuración del lado del servidor, esa señal tiene que recorrer un camino más largo que en el lado del cliente.
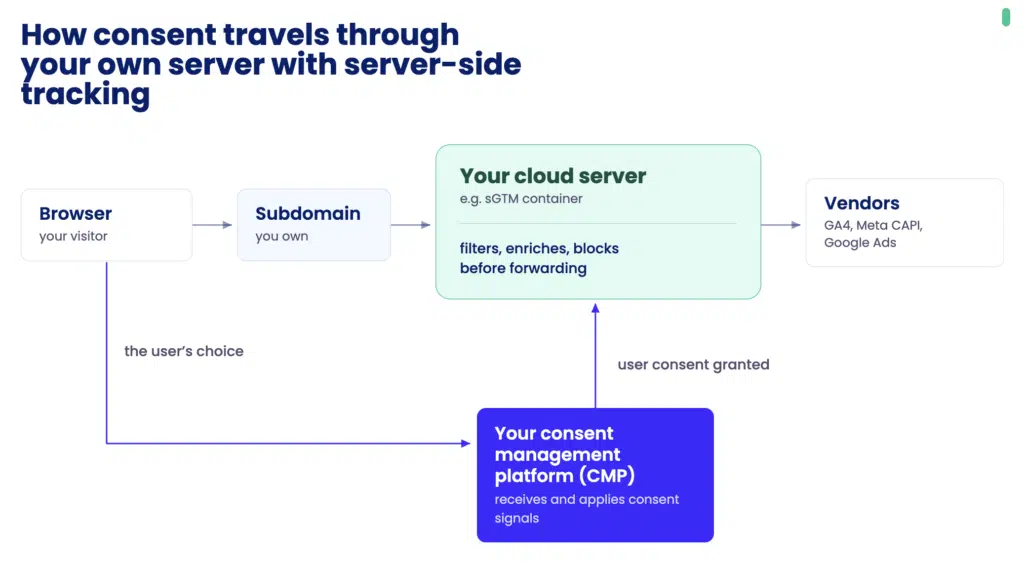
La cadena es corta: tu plataforma de gestión del consentimiento (CMP) recoge la decisión del visitante en el navegador, esa decisión viaja con cada evento hasta el servidor de tracking, y el contenedor decide, para cada destino, si reenvía los datos, los recorta o los descarta.
Para los destinos de Google, esa señal viaja a través de Google Consent Mode. La documentación de Google sobre el lado del servidor describe el mecanismo con claridad: la etiqueta de Google pasa el estado de consentimiento del visitante al contenedor del servidor junto con el evento, y las etiquetas de producto de Google en el servidor ajustan lo que envían en función de esa señal. Google es igual de claro sobre quién es responsable del primer paso: «Eres responsable de obtener el consentimiento de los usuarios en tu web o app». La mayoría de las CMP llevan Consent Mode integrado.
Esto significa que debes asegurarte de que tu configuración de consentimiento sea sólida. Un contenedor que no recibe ninguna señal de consentimiento no queda exento por ello: sigue reenviando datos, y los dashboards siguen llenándose. La primera visita es el caso más difícil, porque en esa primera interacción todavía no se conoce la decisión del visitante. Empieza por una CMP que recoja y almacene el consentimiento de forma fiable, y comprueba después que el servidor lo recibe y actúa en consecuencia.
¿Usar tracking del lado del servidor afecta al cumplimiento?
El tracking del lado del servidor sí afecta a tu nivel de cumplimiento, y si se gestiona bien, el efecto es positivo. Nada de lo anterior lo convierte en una peor opción para la privacidad. De hecho, puede considerarse un método de tracking más respetuoso con la privacidad:
- Aplicas tus reglas a nivel de infraestructura, en un único punto que controlas, en lugar de depender de que el script de cada proveedor las respete.
- Eliges dónde se ejecuta el servidor de tracking, así que una configuración alojada en la UE mantiene el primer paso del tratamiento dentro de la UE. Las transferencias a destinos fuera del EEE siguen necesitando una base del Capítulo V del RGPD.
- Controlas qué campos salen de tu sitio, así que puedes eliminar identificadores o, cuando no puedas, aplicarles hash. El hash reduce la exposición, pero un email o un número de teléfono con hash sigue siendo un dato personal, por lo que le siguen aplicando las mismas obligaciones.
- Menos proveedores llegan directamente al navegador, así que menos terceros independientes leen el dispositivo de cada visitante, y menos scripts están en posición de recopilar información que nunca estuvieron autorizados a recopilar.
- Cada flujo que pasa por el servidor se puede registrar, así que puedes demostrar qué se reenvió y por qué. Eso es evidencia de cumplimiento efectivo: se suma a tus registros de consentimiento del artículo 7(1), pero no los sustituye.
Las configuraciones más sólidas cierran el círculo con su plataforma de gestión del consentimiento: cada evento se comprueba contra la decisión del visitante antes de moverse, se cuenta una sola vez y se envía a cada plataforma posterior a partir de ese único registro verificado.
Cómo es una configuración del lado del servidor conforme
Saber cómo configurar el tracking del lado del servidor es una cosa. Esto es cómo hacerlo para que el cumplimiento se mantenga firme.
- Identifica la base jurídica de cada destino por separado. Un mismo contenedor puede alimentar a seis destinatarios, y puede que no todos se apoyen en la misma base.
- Recaba el consentimiento antes de cualquier acceso al dispositivo, no solo antes de reenviar los datos. El desencadenante es que el navegador lea o escriba, antes de que tu servidor se entere de nada.
- Propaga el estado del consentimiento al contenedor con cada evento. Un contenedor que no puede ver la decisión no puede actuar en consecuencia.
- Elimina los identificadores antes de reenviar siempre que puedas, como direcciones de email y números de teléfono, y aplícales hash cuando no puedas eliminarlos. El hash es minimización, no anonimización: los identificadores con hash siguen siendo datos personales y siguen dentro del ámbito de aplicación. Trata la minimización de datos como la opción por defecto.
- Elige el alojamiento teniendo en cuenta la exposición en las transferencias. Un alojamiento en la UE reduce la exposición en el contenedor, pero cada destino fuera del EEE sigue necesitando su propia base de transferencia.
- Documenta cada destino en tu política de privacidad y de cookies. Un destinatario que no aparece en la política es un destinatario no revelado.
- Verifica qué sale del contenedor, y vuelve a verificarlo después de cada cambio en las etiquetas. Inspecciona el payload de salida en lugar de fiarte de que la configuración se describa a sí misma.
Qué significa esto para ti
La pregunta final que debes responder es si tu configuración concreta cumple lo que exigen las normativas que te aplican: recabar el consentimiento, contar con una base jurídica y explicar tus prácticas en tus políticas.
Las configuraciones más sólidas dejan de tratar la medición y el consentimiento como dos sistemas separados. Esa es la idea detrás de nuestra solución de tracking del lado del servidor: unir el pipeline de tracking y la capa de consentimiento en un solo sistema, en lugar de dos que tienes que conectar tú mismo.
Los eventos se comprueban contra la decisión del visitante antes de moverse, y la configuración predeterminada bloquea cualquier evento sin consentimiento válido.
Preguntas frecuentes
¿Sigo necesitando un banner de cookies si uso tracking del lado del servidor?
Sí, sigues necesitando un banner de cookies si usas tracking del lado del servidor, en cualquier configuración en la que algo lea o escriba en el dispositivo del visitante con fines no exentos. La Directiva ePrivacy vincula la exigencia de consentimiento a ese acceso al dispositivo, y un contenedor del lado del servidor se sitúa después de ese punto.
¿Es posible el tracking publicitario sin consentimiento del lado del servidor?
No, no es posible el tracking publicitario sin consentimiento del lado del servidor. La publicidad y la medición entre sitios quedan fuera de las excepciones de la Directiva ePrivacy, que cubren la transmisión y la estricta necesidad para que un proveedor preste un servicio en línea que el usuario haya solicitado expresamente. El CEPD ha confirmado que el artículo 5(3) se aplica independientemente de qué entidad reciba los datos, así que enviar los eventos a través de un servidor de tracking no crea ninguna excepción que no existiera ya en el lado del cliente.
¿Es el tracking del lado del servidor mejor para la privacidad que el lado del cliente?
El tracking del lado del servidor puede ser mejor para la privacidad que el lado del cliente, pero no lo es de forma automática. Te da un único punto de control donde puedes eliminar identificadores, limitar qué proveedores reciben datos y decidir dónde se procesan, lo cual es preferible a que el script de cada proveedor hable directamente con el navegador.