
Ihre Kampagnen erzeugen mehr Daten als je zuvor – aber kommen sie auch in Ihren Reports an? Adblocker, Browser-Beschränkungen und fehlende Einwilligungen fangen heute einen spürbaren Teil der Kampagnensignale ab, bevor sie Ihre Analytics- oder Werbeplattformen erreichen. Serverseitiges Tracking ist die Antwort, die Sie von Agenturen, Werbevermarktern und aus GTM-Tutorials hören – und es lohnt sich, sie wirklich zu verstehen.
Im IAB State of Data 2024 Report gaben 95 % der Entscheiderinnen und Entscheider aus Werbung und Daten an, mit weiterem Signalverlust zu rechnen; über die Hälfte erwartet, dass Attribution, ROI-Messung und Conversion-Tracking schwieriger werden.
Der Schaden fällt in den meisten Teams kaum auf: Sie verkaufen 100 Mal, Ihre Werbeplattform meldet 60. Budget wandert weg von Kampagnen, die nur scheinbar schwächeln – und das Spiel beginnt von vorn.
Dieser Leitfaden erklärt, was serverseitiges Tracking ist, wie es funktioniert, warum es sich lohnt – und was sich dadurch nicht ändert: Ihre Pflichten bei der Einwilligung.
Kurz gefasst
Beim serverseitigen Tracking, gelegentlich auch serverseitiges Tagging genannt, gehen die Events Ihrer Website zuerst an einen Tracking-Server, der sie bereinigt und anschließend an Ihre Analytics- und Werbeplattformen weitergibt. Das Ergebnis: genauere Conversion-Daten, schnellere Seiten und mehr Kontrolle darüber, was jeder Anbieter erhält. Eines bleibt unverändert – Tracking braucht weiterhin die Einwilligung der Nutzer, Ihre Plattform für Einwilligungsmanagement bleibt also das Herzstück des Setups.
Alles aus diesem Artikel – und mehr – haben wir in einem Whitepaper zum Mitnehmen zusammengefasst.
Kein Formular, keine E-Mail, einfach das PDF.
In diesem Leitfaden:
- Was ist serverseitiges Tracking?
- Serverseitiges Tagging oder serverseitiges Tracking: Wo liegt der Unterschied?
- Clientseitiges vs. serverseitiges Tracking: Wo liegt der Unterschied?
- Wie funktioniert serverseitiges Tracking?
- Die Vorteile von serverseitigem Tracking
- Brauchen Sie serverseitiges Tracking?
- Ersetzt serverseitiges Tracking die Cookie-Einwilligung?
- Serverseitiges Tracking: die Einrichtung je Plattform
- Serverseitiges Tracking einrichten: die Checkliste Schritt für Schritt
- Typische Fehler beim serverseitigen Tracking
- FAQ: serverseitiges Tracking
- Womit Sie anfangen
Was ist serverseitiges Tracking?
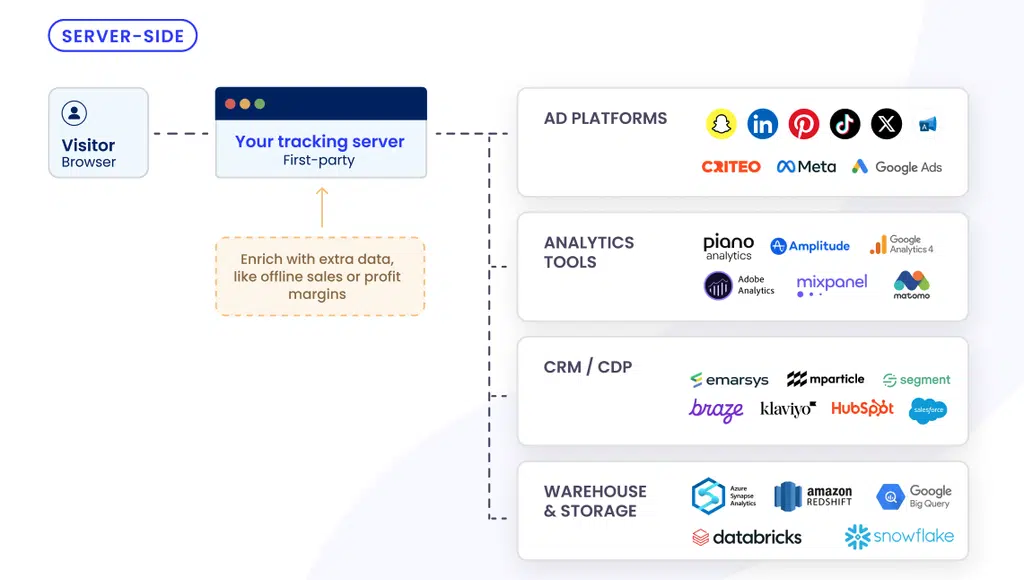
Serverseitiges Tracking ist eine Methode der Datenerfassung, bei der alle Events aus dem Browser Ihrer Besucher an einen einzigen Tracking-Server gehen; dieser verarbeitet die Daten und leitet sie an Ihre Analytics- und Werbeplattformen weiter. Statt Dutzender Third-Party-Skripte, die jeweils direkt aus dem Browser an ihren eigenen Anbieter senden, läuft alles zunächst über einen Server.
Diese Reihenfolge macht den Unterschied: Sie erfassen die Daten zuerst, entscheiden, was davon nützlich ist, bereinigen sie und geben erst dann weiter, was gebraucht wird und wofür eine Einwilligung vorliegt. Mehr Kontrolle für Sie, mehr Datenschutz für Ihre Besucher.
Gleich vorweg zur Beruhigung: Sie müssen dafür keinen Server bauen. Die meisten Marketing-Teams setzen auf eine Managed-Lösung: Der Anbieter betreibt die Infrastruktur, Ihre Arbeit findet im Dashboard statt. Dort steuern Sie die eingehenden Daten und legen fest, was an welchen Anbieter geht.
Ihnen wird außerdem der Begriff „serverseitiges Tagging“ begegnen. Die beiden liegen nah beieinander, sind aber nicht dasselbe – worin genau sie sich unterscheiden, klärt der nächste Abschnitt.
Wenn Sie die Grundlagen noch einmal auffrischen möchten, starten Sie mit unserem Leitfaden dazu, wie Website-Tracking funktioniert.
Serverseitiges Tagging oder serverseitiges Tracking: Wo liegt der Unterschied?
Der Unterschied: Tagging beschreibt die Einrichtung, Tracking das Ergebnis. Serverseitiges Tagging ist die Architektur – Ihre Tags laufen in einem Container auf einem Server statt im Browser Ihrer Besucher. Serverseitiges Tracking ist das, was dabei herauskommt: sauberere Daten, weniger Skripte auf der Seite und Events, die Ihre Plattformen auch dann erreichen, wenn ein Blocker sie sonst gestoppt hätte.
Im Marketing werden beide Begriffe meist synonym verwendet, und das ist in der Regel kein Problem. Die genaue Unterscheidung ist eine rein architektonische.
Clientseitiges vs. serverseitiges Tracking: Wo liegt der Unterschied?
Ob Sie nun von clientseitigem und serverseitigem Tagging oder Tracking sprechen: Entscheidend ist, wo die Daten erfasst werden und wer sie kontrolliert, bevor die Anbieter sie zu sehen bekommen. Den kompletten Direktvergleich finden Sie hier: clientseitiges und serverseitiges Tracking im Vergleich.
| Clientseitiges Tracking | Serverseitiges Tracking | |
|---|---|---|
| Ort der Datenerfassung | Der Browser des Besuchers | Ein Tracking-Server |
| Kontrolle über die Daten | Gering: Skripte erfassen mehr, als sie sollten | Hoch: Sie filtern und bereinigen die Daten, bevor sie zu den Anbietern gehen |
| Genauigkeit | Leidet unter Adblockern und Browser-Beschränkungen | Hält Blockern stand; eingewilligte Events werden genau erfasst |
| Seitenperformance | Schwer: Jedes Anbieter-Skript lädt im Browser | Leicht: weniger Skripte auf der Seite |
| Einrichtung | Einfaches Code-Snippet | Server-Infrastruktur oder eine Managed-Lösung |
| Kosten | Meist kostenlos | Hosting-Kosten oder ein Abo für ein spezialisiertes Tool |
So funktioniert clientseitiges Tracking
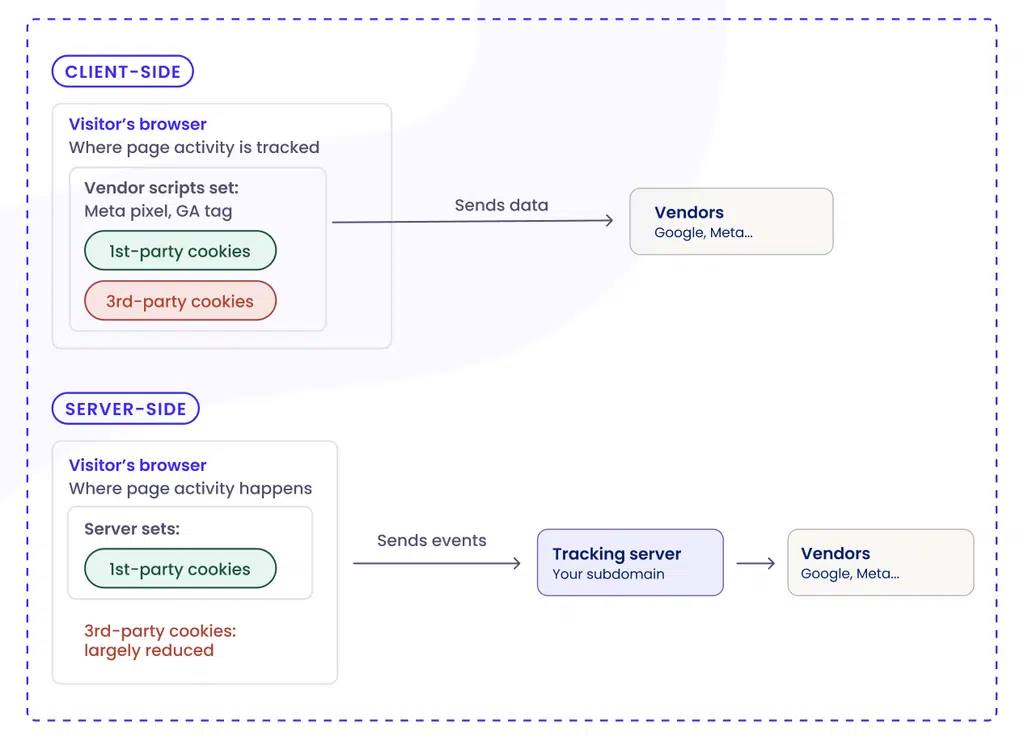
Clientseitiges Tracking ist das klassische Setup: Tags, Pixel und Skripte laden direkt im Browser Ihrer Besucher und senden ihre Daten jeweils an den dahinterstehenden Anbieter – Meta, Google Analytics, Google Ads und Dutzende mehr.
Das funktionierte gut, solange Browser mitspielten und kaum jemand etwas blockierte. Diese Zeiten sind vorbei: Intelligent Tracking Prevention (ITP) in Safari und Enhanced Tracking Protection (ETP) in Firefox schränken Tracking standardmäßig ein, und Adblocker sind längst allgegenwärtig.
Ein verbreiteter Irrtum, den wir gleich ausräumen: Google hat 2025 bestätigt, dass Chrome Third-Party-Cookies doch nicht abschafft. Verschwunden ist das Problem damit nicht. Safari, Firefox und Edge schränken sie längst ein, Adblocker verbreiten sich weiter, und die Datenschutzvorgaben gelten unverändert. Der Signalverlust ist real – unabhängig davon, wie ein einzelner Browser sich entscheidet.
Und so funktioniert serverseitiges Tracking
Beim serverseitigen Tracking sendet der Browser einen einzigen Datenstrom an einen Tracking-Server, in der Regel über eine Subdomain, die Ihnen gehört. Die Anbieter erhalten ihre Daten von diesem Server und nicht mehr aus dem Browser. Weil der Browser nur noch mit Ihrer eigenen Domain spricht, sieht die Anfrage aus wie ganz normaler First-Party-Traffic – und hält Adblockern und Browser-Beschränkungen besser stand. Wie das im Detail abläuft, zeigen die nächsten Abschnitte.
Wie funktioniert serverseitiges Tracking?
Serverseitiges Tracking läuft in vier Schritten ab:
- Der Browser sendet ein Event an einen Tracking-Server. Jemand klickt, meldet sich an oder kauft – und das Event läuft über Ihre eigene Subdomain zum Server.
- Der Server nimmt das Event entgegen und verarbeitet es. Dahinter steckt meist ein serverseitiger Container: eine Cloud-Umgebung, die Events aufnimmt und Ihre Regeln darauf anwendet.
- Der Server filtert und reichert die Daten an. Sie verwerfen, was Sie nicht brauchen, hashen oder entfernen personenbezogene Angaben und ergänzen Kontext wie den Bestellwert, bevor irgendetwas hinausgeht.
- Der Server gibt saubere Daten an Ihre Plattformen weiter. GA4, Meta, Google Ads und alle anderen erhalten ihre Events Server zu Server.
Die Rolle des serverseitigen Containers
Am häufigsten kommt ein serverseitiger Google-Tag-Manager-Container zum Einsatz, kurz Server-side GTM oder sGTM. Serverseitige Setups arbeiten im Google Tag Manager mit zwei Containern: dem Web-Container auf Ihrer Website und dem Server-Container in der Cloud. Diesen Server-Container können Sie selbst hosten oder über eine Managed-Lösung betreiben lassen – die Konfiguration bleibt in Ihrer Hand: Ihr Tracking-Setup, Ihre Regeln.
Warum die eigene Subdomain entscheidend ist
Ein Adblocker tut im Kern genau das, was sein Name verspricht: Er verhindert, dass Online-Werbung angezeigt wird. Mit der Zeit haben die meisten Blocker ihren Radius von der Werbung auf die Tracking-Skripte ausgeweitet, die mit ihr kommen. Im Ergebnis verhindern Adblocker, dass Third-Party-Skripte Daten sammeln, in die niemand eingewilligt hat.
Serverseitiges Tracking entfernt diese Skripte vollständig von der Seite. Was übrig bleibt, ist kein Tracking, das am Blocker vorbeigeschlüpft ist, sondern First-Party-Messung mit Einwilligung – also genau das, wogegen Blocker nie gebaut wurden. Der Browser spricht nur noch mit Ihrer eigenen Subdomain: Die Anfrage wirkt wie First-Party-Traffic statt wie ein bekannter Tracker und landet seltener auf der Blockliste. Von dort gibt Ihr Server die Daten von Server zu Server an die Anbieter weiter – dorthin haben Adblocker keinen Einblick.*
*Manche Adblocker gehen weiter und sperren eine Tracking-Subdomain komplett, sobald sie erkennen, dass sie der Datenerfassung dient. Serverseitiges Tracking macht Signalverlust also deutlich unwahrscheinlicher, aber nicht unmöglich.
Die Vorteile von serverseitigem Tracking
Die Vorteile von serverseitigem Tagging verteilen sich auf vier Bereiche – und sie verstärken sich gegenseitig.
Genauere Daten und Attribution
Diesen Vorteil bemerken die meisten Marketing-Teams zuerst. Weil Sie Tracking-Daten über einen Server auf Ihrer eigenen Domain entgegennehmen, hält Ihr Tracking Adblockern und Browser-Beschränkungen besser stand. Beispiel: Die Intelligent Tracking Prevention von Safari begrenzt per JavaScript im Browser gesetzte Cookies auf 7 Tage. Cookies, die ein Server in der HTTP-Antwort setzt, halten länger – allerdings kappt Safari auch sie nach 7 Tagen, wenn die Tracking-Subdomain auf einen Dritten verweist. Wie die Subdomain konfiguriert ist, macht also einen Unterschied.
Serverseitiges Tracking macht Conversions sichtbar, die es immer schon gab, die aber nie in den Reports ankamen. Und das trifft die Kennzahl, die Werbetreibende am meisten interessiert: Return on Ad Spend (ROAS).
Aussagekräftigere Daten
Weil jedes Event zuerst über einen Server läuft, können Sie diesen Server mit Ihren eigenen Systemen verbinden – etwa Ihrem CRM oder Ihrer Bestelldatenbank – und die Daten vor der Weitergabe anreichern. Das nennt sich serverseitige Datenanreicherung, und Googles wertbasierte Gebotsstrategien und Conversion-Wert-Regeln sind genau für solche Signale gemacht.
Hängen Sie an ein Event die Marge eines Kaufs oder den Customer Lifetime Value, lässt sich der Algorithmus auf Gewinn und wertvolle Kunden ausrichten statt nur auf Umsatz.
Schnellere Seiten
Jedes Tracking-Skript bringt zusätzliches Gewicht mit, das der Browser laden und ausführen muss, während sich Ihre Seite gerade aufbaut – das kostet Tempo, besonders mobil.
Serverseitiges Tracking verlagert den größten Teil dieser Arbeit weg vom Browser. Weniger Skripte auf der Seite bedeuten kürzere Ladezeiten, bessere Core Web Vitals und mehr SEO-Potenzial. Und Tempo zahlt direkt auf den Umsatz ein: Eine Seite, die in 1 Sekunde lädt, konvertiert bis zu 3-mal besser als eine, die 5 Sekunden braucht.
Mehr Kontrolle über Ihre Compliance
Wenn jedes Event über einen einzigen Tracking-Server läuft, lässt sich Data Governance endlich wirklich durchsetzen. Der Server ist der eine Kontrollpunkt, den jedes Event passiert – und damit der Ort, an dem Sie die Regeln festlegen:
- Senden Sie nur, was Sie brauchen. Datenminimierung ist ein Grundprinzip der Datenschutz-Grundverordnung (DSGVO). Serverseitig wird sie praktikabel: Sie geben die Felder weiter, die ein Anbieter zur Erfassung einer Conversion braucht, und lassen den Rest weg.
- Hashen oder entfernen Sie personenbezogene Daten. Für jedes Ziel entscheiden Sie, was hinausgeht: Feld streichen, hashen oder unverändert übergeben. Achtung: Hashing ist Pseudonymisierung, keine Anonymisierung. Eine gehashte E-Mail-Adresse gilt weiterhin als personenbezogenes Datum und braucht eine Rechtsgrundlage. Trotzdem begrenzt Hashing, was ein Anbieter mit dem Feld über den nötigen Abgleich hinaus anfangen kann. Ein Praxishinweis: Jeder Anbieter legt Mindestanforderungen dafür fest, was ein Event enthalten muss, um akzeptiert und zugeordnet zu werden – wie viel Sie streichen können, hängt also vom Ziel ab.
- Stoppen Sie Datenabfluss an der Quelle. Weil die Übergabe Server zu Server läuft, können Third-Party-Skripte den Browser nicht mehr nach Informationen durchsuchen, für die sie keine Erlaubnis haben.
- Protokollieren Sie lückenlos. Halten Sie jeden Datenfluss fest und bauen Sie damit genau die Nachweise auf, die Aufsichtsbehörden zunehmend erwarten.
First-Party-Daten: das eigentliche Kapital
All das führt zu einer strategischen Verschiebung: Sie bauen ein Datenkapital auf, das Ihnen gehört, statt Signale von Dritten zu mieten, die gerade verschwinden. First-Party-Daten erheben Sie direkt über Ihre eigenen Kanäle – sie sind verlässlicher und datenschutzfreundlicher als Third-Party-Daten.
Die Branche hat den Schritt längst gemacht: 71 % der Marken, Agenturen und Publisher bauen ihre First-Party-Datenbestände aus, und BCG hat ermittelt, dass Unternehmen, die ihre First-Party-Datenquellen verknüpfen, aus einer einzelnen Anzeigenplatzierung den 1,5-fachen zusätzlichen Umsatz erzielen und ihre Kosteneffizienz doppelt so stark verbessern.
Der Haken: First-Party-Daten bringen nur etwas, wenn Sie sie rechtmäßig erheben, über Ihre Tools hinweg aktivieren und nutzen können. Über alle drei Punkte entscheidet die Einwilligung – wer die Einwilligungsebene falsch aufsetzt, vererbt die Lücke an jedes nachgelagerte Tool.
Wie Andreea Mandeal, CMO von iubenda, es für das IAB Tech Lab formuliert: Ohne ein verlässliches Einwilligungs-Framework lassen sich First-Party-Daten „von keinem nachgelagerten Team mit Sicherheit nutzen“.
Brauchen Sie serverseitiges Tracking?
Bevor Sie in serverseitiges Tracking investieren, machen Sie den kurzen Realitätscheck anhand der folgenden Fragen:
- Setzen Sie Werbebudget ein und brauchen genaue Conversion-Daten, um Kampagnen zu optimieren?
- Vergleichen Sie die Conversions, die Ihre Werbeplattform meldet, mit dem, was Sie tatsächlich verkauft haben: Passen die Zahlen zusammen?
- Fließt eine genaue Attribution in echte Budgetentscheidungen ein – oder landet sie nur im Reporting?
- Bauen Sie eine First-Party-Datenstrategie auf, die Sie zuverlässig aktivieren müssen?
- Erheben Sie Ihre Daten bereits über eine saubere Einwilligungsebene?
→ Wenn Sie mehrere Fragen mit Ja beantwortet haben, lohnt sich die Investition in serverseitiges Tracking jetzt. Das wichtigste Signal ist die Lücke zwischen gemeldeten und tatsächlichen Conversions – genau dort versickert Budget.
→ Noch nicht der richtige Moment ist es, wenn Ihre Analytics-Anforderungen überschaubar sind und Sie kein Werbebudget ausgeben – oder wenn Ihnen die technischen Ressourcen fehlen und eine Managed-Lösung, die den Großteil der komplexen Arbeit übernimmt, noch nicht infrage kommt. Dasselbe gilt, wenn Sie Daten bisher nicht über eine Einwilligungsebene erheben.
Ersetzt serverseitiges Tracking die Cookie-Einwilligung?
Nein, serverseitiges Tracking ersetzt die Cookie-Einwilligung nicht. Es verändert, wo Ihre Daten verarbeitet werden, nicht, ob Sie dafür eine Erlaubnis brauchen. Was im Browser einwilligungspflichtig war, bleibt es auch auf dem Server. Das ist zugleich der hartnäckigste Mythos rund um serverseitiges Tracking und die DSGVO – deshalb lohnt sich ein genauer Blick.
Warum serverseitiges Tracking auch unter der DSGVO eine Rechtsgrundlage braucht
Die DSGVO verlangt für die Verarbeitung personenbezogener Daten eine Rechtsgrundlage (Artikel 6), und beim Marketing-Tracking ist das in den meisten Fällen die Einwilligung. Die ePrivacy-Richtlinie der EU – das sogenannte Cookie-Gesetz – kommt mit einer eigenen Regel dazu: Das Speichern von Kennungen auf dem Gerät eines Nutzers oder der Zugriff darauf ist grundsätzlich einwilligungspflichtig, ganz gleich, wohin die Daten danach wandern.
Der Umzug auf einen Server ändert die Architektur, nicht die Pflichten:
- Eine Plattform für Einwilligungsmanagement (CMP) bleibt der Baustein, der die Entscheidung jedes Besuchers erfasst.
- Ihr Setup für das Cookie-Einwilligungsmanagement muss diese Entscheidung an den Tracking-Server übergeben, damit er ausschließlich eingewilligte Daten weitergibt.
- Auch Ihre Datenschutzerklärung und Ihre Cookie-Richtlinie müssen abbilden, was Sie erheben und wer die Daten erhält; ein Generator für Datenschutzerklärungen hält diese Dokumentation auf dem Stand Ihres tatsächlichen Setups.
Weil serverseitige Verarbeitung für Nutzer weniger sichtbar ist als Skripte im Browser, wird Transparenz wichtiger, nicht unwichtiger.
In der Praxis hängt sie an drei Dingen:
- ein Cookie-Banner, das die serverseitige Verarbeitung erklärt und begründet, warum welcher Anbieter Daten erhält,
- Einwilligungssignale, die mit jedem Event an jeden Partner mitgehen,
- ein protokollierter Einwilligungsnachweis, mit dem Sie belegen können, wer worin eingewilligt hat.
Eine bekannte Hürde, die Sie einplanen sollten: Beim allerersten Kontakt eines Besuchers ist sein Einwilligungsstatus noch nicht bekannt. Dass Einwilligungsebene und Server in genau diesem Moment sauber miteinander sprechen, erfordert eine sorgfältige Einrichtung.
Serverseitiges Tracking: die datenschutzbewusstere Art, Marketing zu messen
Serverseitig gehen Sie respektvoller mit Nutzerdaten um: Alles läuft über einen einzigen Kontrollpunkt, bevor es irgendwen sonst erreicht – und das verändert, womit Ihre Besucher überhaupt in Berührung kommen.
Dieselbe Architektur, die Ihre Signale zurückholt, gibt Ihnen auch mehr Kontrolle über die Daten: Eingewilligte Daten werden sorgfältiger behandelt, und Daten ohne Einwilligung verlassen die Seite gar nicht erst.
Eine zweite datenschutzbewusste Methode, Tracking-Signale zurückzugewinnen, sollten Marketer ebenfalls kennen: Google Consent Mode. Er sagt den Google-Tags, wie sie sich verhalten sollen – je nachdem, wofür sich jemand auf Ihrem Cookie-Banner entschieden hat. Willigt jemand ein, läuft das Tracking normal. Lehnt jemand ab, sendet die erweiterte Variante begrenzte, cookielose Pings und schließt die Lücke über aggregierte Modellierung statt über individuelles Tracking.
- Serverseitiges Tracking sichert so viele Ihrer eingewilligten Daten wie möglich – auch den Teil, der sonst verloren ginge.
- Consent Mode deckt den Rest ab und schließt die Lücke bei allen, die ablehnen.
Zusammen ergeben sie ein vollständigeres, datenschutzbewusstes Bild Ihrer Performance – und beide setzen voraus, dass Ihre CMP überhaupt erst eine gültige Einwilligung einholt.
Serverseitiges Tracking: die Einrichtung je Plattform
Serverseitiges Tagging funktioniert auf jeder Plattform etwas anders. GA4, Meta, Google Ads, Shopify und WordPress bringen jeweils ihren eigenen serverseitigen Mechanismus mit, folgen aber alle demselben Muster: Der Tracking-Server schickt Events direkt an die Server der Plattform, ohne Umweg über den Browser.
| Plattform | Serverseitiger Mechanismus | Was Sie brauchen |
|---|---|---|
| GA4 | Serverseitiger GTM-Container | Ein sGTM-Container (selbst gehostet oder als Managed-Lösung) mit einem GA4-Tag |
| Meta (Facebook und Instagram) | Conversions API (CAPI) | Eine CAPI-Anbindung, meist über sGTM oder eine Plattform-Integration |
| Google Ads | Erweiterte Conversions und serverseitiges Conversion-Tracking | Conversion-Tags, die über denselben Server-Container laufen |
| TikTok, LinkedIn, Microsoft Ads | TikTok Events API, LinkedIn Conversions API, Microsoft Ads UET | Die Server-zu-Server-API der jeweiligen Plattform, gespeist aus dem Tracking-Server |
| Shopify, WooCommerce, WordPress | sGTM oder Plattform-Integrationen | Eine Verbindung zwischen Ihrem Shop oder Ihrer Website und dem Server-Container |
Ein paar Hinweise zur Einordnung:
- GA4 und Google Ads nutzen denselben Server-Container: Ist eines eingerichtet, folgt das andere meist mit wenig Zusatzaufwand.
- Meta, TikTok, LinkedIn und Microsoft Ads haben jeweils ihren eigenen Weg, Events von einem Server entgegenzunehmen (bei Meta heißt er Conversions API), das Prinzip bleibt aber dasselbe: Die Events erreichen die Plattform direkt, nicht über den Browser.
- Shopify und WooCommerce binden Sie über Integrationen an, sodass Käufe in Ihrem Shop erfasst werden und nicht im Browser des Käufers.
Serverseitiges Tracking einrichten: die Checkliste Schritt für Schritt
So sieht die Umsetzung in der Regel aus – unabhängig davon, für welche Tools Sie sich entscheiden:
- Server-Ebene aufsetzen. Richten Sie einen Tracking-Server in der Cloud ein, meist einen sGTM-Container. Entweder hosten Sie ihn selbst oder Sie nutzen eine Managed-Lösung, die das für Sie übernimmt (deutlich einfacher).
- Eigene Subdomain darauf zeigen lassen. Legen Sie auf Ihrer Domain eine Subdomain an (etwa
analytics.ihredomain.de) und leiten Sie sie per DNS-Eintrag auf den Server. - CMP anbinden. Binden Sie die Einwilligungssignale an den Server an, damit nichts ausgelöst wird, bevor sich ein Besucher entschieden hat. Dieser Schritt hält die gesamte Pipeline sauber.
- Festlegen, was durchgeht. Definieren Sie, was gefiltert, angereichert oder blockiert wird, bevor Daten an einen Anbieter gehen.
- Ziele anbinden. Schicken Sie die Events weiter an die Plattformen, die Sie nutzen: GA4, Meta CAPI, Google Ads und den Rest.
- Datenschutzdokumente aktualisieren. Sorgen Sie dafür, dass Datenschutzerklärung und Cookie-Richtlinie die Datenflüsse und die empfangenden Anbieter abbilden.
- Beide Setups parallel laufen lassen. Lassen Sie das clientseitige Tracking ein bis zwei Wochen weiterlaufen und vergleichen Sie die Zahlen. Passen sie zusammen, können Sie der neuen Pipeline vertrauen.
- Überwachen und pflegen. Prüfen Sie Einwilligungssignale, Datenflüsse und das, was jeder Anbieter erhält – und behalten Sie es im Blick, wenn sich Plattformen und Regeln ändern.
Planen Sie das Team gleich mit ein: Das Marketing verantwortet Tracking-Konfiguration und Ziele, die Entwicklung kümmert sich um Subdomain und Routing. Mit einer Managed-Lösung schrumpft der technische Aufwand deutlich.
Typische Fehler beim serverseitigen Tracking
Serverseitige Setups sind mächtig – und damit auch schnell falsch konfiguriert. Die häufigsten Fehlerquellen:
- Doppelt gezählte Conversions. Wer ein Browser-Pixel und eine serverseitige Anbindung ohne Deduplizierung betreibt, zählt denselben Kauf zweimal – und aufgeblähte Zahlen führen genauso in die Irre wie fehlende.
- Ungehashte personenbezogene Daten in Server-Payloads. Mehr Zugriff auf Daten heißt mehr Verantwortung. Hashen oder entfernen Sie Identifikatoren, bevor Events den Server verlassen.
- Eine falsch konfigurierte First-Party-Subdomain. Stimmt das DNS-Routing nicht, reißt die Verbindung ab – und es kann Wochen dauern, bis das jemandem auffällt.
- Den Einwilligungsstatus in Server-Payloads ignorieren. Der Server muss die Tracking-Entscheidung jedes Besuchers erhalten und respektieren, auch beim heiklen ersten Besuch. Events ohne Einwilligung von einem Server weiterzugeben, bleibt Tracking ohne Einwilligung – und damit nicht rechtskonform.
- Serverseitiges Tracking als unsichtbar behandeln. Nutzer können serverseitige Verarbeitung nicht so nachvollziehen, wie sie Cookies einsehen. Erklären Sie sie deshalb offen im Cookie-Banner und in Ihren Datenschutzdokumenten: Je weniger sichtbar die Technik, desto wichtiger die Transparenz.
Womit Sie anfangen
Serverseitiges Tracking holt Ihnen die verlorenen Signale zurück und gibt Ihnen mehr Kontrolle darüber, was Ihre Website verlässt. Nutzbar sind die zurückgewonnenen Daten aber nur, wenn die Einwilligung mitreist. Genaue Messung und Respekt vor der Privatsphäre sind kein Gegensatz – die besten Setups behandeln sie als ein und dasselbe Ziel.
Serverseitiges Tracking mit eingebauter Compliance
Die Compliance richten Sie gleich mit ein
FAQ: serverseitiges Tracking
Ist serverseitiges Tracking DSGVO-konform?
Serverseitiges Tracking unterstützt Sie bei der DSGVO-Compliance, liefert sie aber nicht von allein. Es verändert, wo Daten verarbeitet werden, nicht, ob die DSGVO greift. Für die Verarbeitung personenbezogener Daten brauchen Sie überall eine Rechtsgrundlage, Ihre Pflichten bleiben also dieselben. Der eine echte Unterschied: Auf dem Server können Sie filtern, was hinausgeht – und Daten, die sich keiner Person mehr zuordnen lassen (also wirklich anonymisierte Daten), sind keine personenbezogenen Daten im Sinne der DSGVO.
Braucht serverseitiges Tracking eine Cookie-Einwilligung?
Ja, serverseitiges Tracking braucht eine Cookie-Einwilligung. Die Einwilligungspflicht knüpft an den Moment an, in dem etwas auf dem Gerät eines Besuchers gelesen oder gespeichert wird – nicht daran, wohin die Daten danach wandern. Was im Browser einwilligungspflichtig war, ist es serverseitig genauso. Ihre CMP muss die Entscheidung jedes Besuchers an den Tracking-Server weitergeben, damit nur eingewilligte Daten weiterlaufen.
Ist serverseitiges Tagging zulässig?
Ja, serverseitiges Tagging ist zulässig, solange Ihre Einwilligungsinfrastruktur sauber aufgesetzt ist. Rechtmäßig wird Tracking nicht durch den Ort, an dem es läuft, sondern durch die Rechtsgrundlage dahinter. Der Umzug Ihrer Tags auf einen Server ändert die Architektur, nicht Ihre Pflichten: Was im Browser eine Einwilligung brauchte, braucht sie auch serverseitig. Wir empfehlen dringend eine Plattform für Einwilligungsmanagement wie iubenda, die die Entscheidung jedes Besuchers an den Tracking-Server übergibt, damit nur eingewilligte Daten weitergereicht werden.
Ist serverseitiges Tracking schwierig einzurichten?
Serverseitiges Tracking bedeutet echten Einrichtungsaufwand – wie viel, hängt vom gewählten Weg ab. Der Eigenbau ist komplex und kostet Entwicklungszeit: Container, Subdomain, Server und Routing aufsetzen und das Ganze dauerhaft pflegen. Mit einer Managed-Lösung fällt der größte Teil davon weg. Den Server betreibt der Anbieter, Ihr Part spielt sich im Dashboard ab: entscheiden, was erfasst, gefiltert und weitergegeben wird.
Brauche ich für serverseitiges Tagging den Google Tag Manager?
Nein, für serverseitiges Tagging brauchen Sie den Google Tag Manager nicht, auch wenn sGTM der häufigste Weg ist. Es zählt jedes Setup, das Events auf einem Server entgegennimmt und an Ihre Anbieter weitergibt. sGTM ist beliebt, weil die Konfiguration kostenlos ist, GA4 und Google Ads sofort funktionieren und es dazu die meiste Dokumentation gibt.
Was kostet serverseitiges Tagging?
Die Kosten für serverseitiges Tagging entstehen durch das Cloud-Hosting des Server-Containers und richten sich danach, wie viel Traffic Sie darüber schicken. Wenn Sie statt des Eigenhostings ein Managed-Abo nutzen, steckt das in Ihrer Abogebühr. Dasselbe gilt für Einrichtung und Wartung – der Posten, den Teams am häufigsten unterschätzen. Unterm Strich geht es also um Hosting, Einrichtung und Pflege samt der Zeit, die Ihr Team (sprich: Ihre Entwickler) dafür aufwendet.
Ersetzt serverseitiges Tracking Cookies vollständig?
Nein. Serverseitiges Tracking macht Ihr Tracking weniger abhängig von Cookies, schafft sie aber nicht ab. Die Weitergabe an die Anbieter läuft Server zu Server, deshalb werden die Third-Party-Cookies, die Anbieter-Skripte früher im Browser gesetzt haben, weitgehend überflüssig. First-Party-Cookies nutzt Ihre Website in der Regel weiterhin, um wiederkehrende Besucher zu erkennen – jetzt vom Server gesetzt und dadurch langlebiger. An den Einwilligungspflichten für diese Cookies ändert sich nichts.
Clientseitiges oder serverseitiges Tracking: Was passt zu mir?
Serverseitiges Tracking ist die richtige Wahl, wenn Sie Werbebudget einsetzen, genaue Conversion-Daten brauchen oder eine First-Party-Datenstrategie aufbauen. Clientseitig kann weiterhin genügen, wenn Ihre Anforderungen überschaubar sind und Sie keine Werbekampagnen schalten.