
Ihre Werbeplattform meldet weniger Conversions, als Ihr Shop tatsächlich verbucht hat. Kommt Ihnen das bekannt vor? Oft liegt die Lücke an einer einzigen Entscheidung: clientseitiges oder serverseitiges Tracking.
Clientseitiges Tracking schickt die Daten direkt aus dem Browser der Besucher an jeden einzelnen Anbieter, etwa Meta und Google. Serverseitiges Tracking schickt sie zunächst an einen Tracking-Server, der sie von dort weiterleitet. Diese eine Umstellung entscheidet darüber, wie viele Daten Ihnen erhalten bleiben, wie schnell Ihre Seiten laden und wie viel Kontrolle Sie darüber haben, was bei welchem Anbieter ankommt.
Kurz gefasst
Clientseitiges Tracking schickt die Daten direkt aus dem Browser der Besucher an jeden Anbieter. Serverseitiges Tracking leitet sie zuerst über einen Tracking-Server: So verlieren Sie weniger Daten, für die eine Einwilligung vorliegt, und bestimmen selbst, was bei welchem Anbieter ankommt – zu laufenden Kosten. Eine Einwilligung der Nutzer ist in beiden Fällen erforderlich.
In diesem Leitfaden:
- Was ist clientseitiges Tracking?
- Was ist serverseitiges Tracking?
- Clientseitiges vs. serverseitiges Tracking: die wichtigsten Unterschiede
- Warum clientseitiges Tracking Daten verliert
- Benötigt serverseitiges Tracking weiterhin eine Einwilligung?
- Checkliste: Wofür sollten Sie sich entscheiden?
- FAQ: clientseitiges vs. serverseitiges Tracking
Was ist clientseitiges Tracking?
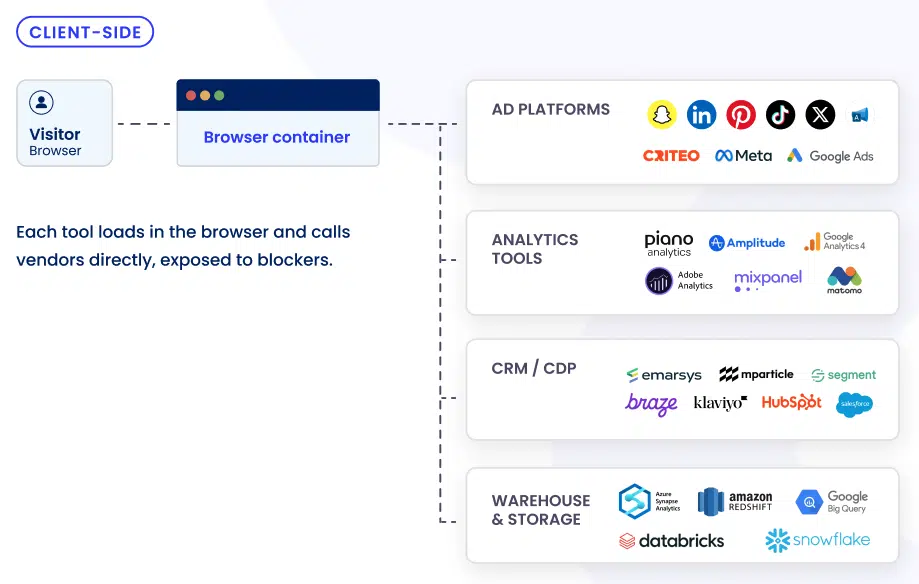
Clientseitiges Tracking ist der Standardweg, auf dem Websites das Verhalten ihrer Besucher messen: welche Seiten sie aufrufen, wie sie sich durch Ihre Website bewegen, über welche Anzeige sie gekommen sind und ob sie kaufen oder sich registrieren. Tags, Pixel und Skripte werden im Browser der Besucher geladen und senden ihre Daten jeweils direkt an den eigenen Anbieter – etwa Meta, Google Analytics oder Google Ads.
Angenommen, jemand gelangt über eine Instagram-Anzeige auf Ihre Produktseite. Im Browser wird das Meta Pixel ausgelöst und meldet den Besuch an Meta. Google Analytics tut dasselbe für Google – getrennt davon.
Das hat gute Gründe: Sie fügen einen Integrationscode ein, und es läuft – meist sogar kostenlos. Der Preis dafür: Jedes Skript läuft im Browser der Besucher, wo Browser-Beschränkungen und Adblocker es stoppen können, und jedes macht die Seite ein Stück schwerer.
Was ist serverseitiges Tracking?
Serverseitiges Tracking verlagert die Erhebung von Marketingdaten vom Browser auf einen Server. Statt jeden Anbieter einzeln anzusprechen, sendet der Browser einen einzigen Datenstrom an einen Tracking-Server auf einer Subdomain Ihrer Website. Dort haben Sie mehr Kontrolle über die Daten – Sie filtern und reichern sie an – und erst danach gehen sie an Plattformen wie Google und Meta.
Das heißt nicht, dass Sie selbst einen Server aufsetzen müssen. Die meisten Marketingteams setzen auf einen Managed Service: Der Anbieter betreibt die Infrastruktur, Sie steuern die Regeln im Dashboard. Einen vollständigen Überblick gibt unser Beitrag dazu, wie serverseitiges Tracking funktioniert.
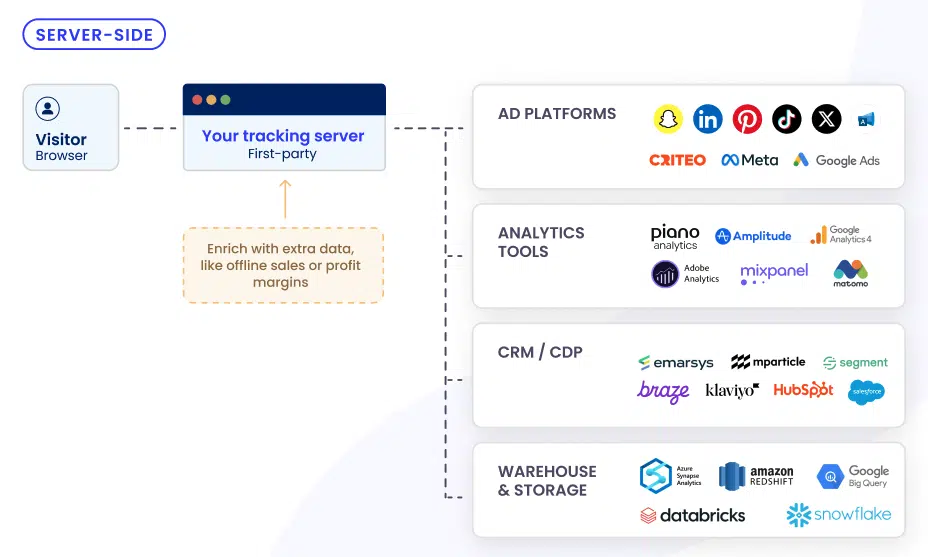
Weil der Tracking-Server auf einer Subdomain Ihrer Website liegt, findet die Datenerhebung in einem First-Party-Kontext statt. Der Browser spricht mit Ihrer Website statt mit der Domain eines Anbieters, und der Server kann First-Party-Cookies selbst setzen. Genau deshalb ist serverseitiges Tracking die Grundlage einer First-Party-Datenstrategie.
Clientseitiges vs. serverseitiges Tracking: die wichtigsten Unterschiede
Clientseitiges und serverseitiges Tracking im direkten Vergleich:
| Clientseitiges Tracking | Serverseitiges Tracking | |
|---|---|---|
| Wo Daten erhoben werden | Im Browser der Besucher | Auf einem Tracking-Server, der einen einzigen Datenstrom aus dem Browser empfängt |
| Wer bestimmt, was Anbieter erhalten | Das Skript jedes Anbieters – es kann die gesamte Seite auslesen | Sie selbst: Sie filtern und bereinigen die Daten (Hashing), bevor sie an die Anbieter gehen |
| Anfälligkeit für Adblocker und Browser-Beschränkungen | Hoch: Die Skripte rufen Anbieter-Domains direkt auf | Geringer: Der Browser spricht nur mit Ihrer eigenen Subdomain |
| Cookies | Third-Party-Cookies der Anbieter sowie First-Party-Cookies, die im Browser gesetzt werden | Überwiegend First-Party-Cookies, vom Server gesetzt und länger gültig |
| Ladezeit | Jedes Skript macht die Seite schwerer | Weniger Skripte im Browser, dadurch schnellere Ladezeiten |
| Einrichtung | Ein Integrationscode | Ein Tracking-Server und eine eigene Subdomain – oder ein dedizierter Managed Service (Tool für serverseitiges Tracking) |
| Kosten | Meist kostenlos | Laufende Hosting- oder Abokosten |
| Einwilligung der Nutzer | Erforderlich | Erforderlich |
Warum clientseitiges Tracking Daten verliert
Beim clientseitigen Tracking rufen die Tags ihren jeweiligen Anbieter direkt aus dem Browser auf – jede Anfrage liegt damit offen. Browser beschränken Tracking inzwischen standardmäßig, etwa mit Intelligent Tracking Prevention (ITP) in Safari und Enhanced Tracking Protection (ETP) in Firefox. Adblocker sind weit verbreitet und blockierten anfangs nur Werbung. Die meisten stoppen inzwischen auch die Tracking-Skripte, die damit einhergehen.
Serverseitiges Tracking ändert den Weg der Daten. Der Browser spricht nur noch mit einem Tracking-Server auf Ihrer eigenen Subdomain, sodass die Anfrage wie First-Party-Traffic aussieht und nicht wie ein bekannter Tracker. Anschließend gibt der Server die Daten von Server zu Server an Google oder Meta weiter – ein Bereich, in den Adblocker keinen Einblick haben. Das setzt sich über niemandes Entscheidung hinweg: Adblocker sollen Datenerhebungen verhindern, in die niemand eingewilligt hat, und serverseitig bleibt die Messung erhalten, in die die Nutzer sehr wohl eingewilligt haben.
Serverseitiges Tracking ist nicht unfehlbar, kann aber einen guten Teil der Daten zurückholen. Manche Adblocker sperren eine Tracking-Subdomain, sobald sie deren Zweck erkennen – Datenverlust wird also unwahrscheinlicher, nicht unmöglich. Und fehlende Daten kosten real: Ihre Werbeplattformen optimieren auf einem unvollständigen Bild, und Ihr Budget folgt dieser Lücke.
Benötigt serverseitiges Tracking weiterhin eine Einwilligung der Nutzer?
Ja, auch serverseitiges Tracking braucht eine Einwilligung. Die Verlagerung auf einen Server ändert nur, wo Daten verarbeitet werden – nicht, ob Sie dafür eine Erlaubnis brauchen. Die EU-ePrivacy-Richtlinie verlangt eine Einwilligung, bevor etwas auf dem Gerät der Besucher gelesen oder dort gespeichert wird, und die Datenschutz-Grundverordnung (DSGVO) regelt den Umgang mit den personenbezogenen Daten danach. Alle rechtlichen Details finden Sie in unserem Beitrag dazu, ob serverseitiges Tracking DSGVO-konform ist.
In einer sauber aufgesetzten Umgebung entscheidet die Einwilligung über alles Weitere. Ihre Plattform für Einwilligungsmanagement legt fest:
- welche Cookies und Kennungen Ihre Website setzen darf,
- ab wann Tracking starten darf,
- welche Anbieter Daten erhalten.
Verbinden Sie Ihre Plattform für Einwilligungsmanagement mit dem Tracking-Server, leitet dieser nur noch Daten weiter, für die eine Einwilligung vorliegt. Die Besucher entscheiden sich dafür oder dagegen in Ihrem Cookie-Banner.
Checkliste: Wofür sollten Sie sich entscheiden?
Clientseitiges oder serverseitiges Tracking? Das hängt davon ab, wie stark Ihr Budget an Conversion-Daten hängt und ob die Einwilligung bereits sauber geregelt ist. Gehen Sie dazu die folgenden Fragen durch.
- Fangen Sie hier an: Holen Sie Einwilligungen über eine Plattform für Einwilligungsmanagement ein? Falls nicht, richten Sie das zuerst ein. Ein Tracking-Server leitet nur weiter, wofür eine Einwilligung vorliegt – ohne diese Ebene gibt es nichts, was er zuverlässig senden könnte. Für eine einfache Einrichtung hat iubenda Einwilligungsmanagement und serverseitiges Tracking in einem System zusammengeführt.
Serverseitiges Tracking lohnt sich wahrscheinlich, wenn Sie mehrere dieser Fragen mit Ja beantworten:
- Schalten Sie bezahlte Werbung und brauchen genaue Conversion-Daten, um Ihre Kampagnen zu optimieren?
- Melden Ihre Werbeplattformen weniger Conversions, als Sie tatsächlich verkauft haben? Das ist das deutlichste Signal, denn in dieser Lücke versteckt sich verschwendetes Budget.
- Steuert die Attribution echte Budgetentscheidungen – nicht nur das Reporting?
- Bauen Sie First-Party-Daten auf, die in all Ihren Tools zuverlässig nutzbar sein müssen?
- Haben Sie die technische Unterstützung, um einen Tracking-Server zu betreiben – oder kommt ein Managed Service infrage, der Ihnen das abnimmt?
Clientseitiges Tracking dürfte vorerst genügen, wenn Sie diese Fragen mit Ja beantworten:
- Genügen Ihnen Basiskennzahlen wie Traffic, meistbesuchte Seiten und Quellen?
- Schalten Sie wenig oder gar keine bezahlte Werbung?
- Wiegen Kosten und Pflege eines Tracking-Servers schwerer als die Daten, die er zurückholt?
- Liegen Ihre gemeldeten Conversions schon nah an Ihren tatsächlichen Verkäufen?
Sie müssen nicht alles auf einmal umstellen. Meta etwa empfiehlt, die Conversions API parallel zum Meta Pixel zu betreiben, sodass beide zusammenspielen. Ein zweiter häufiger Einstieg ist der serverseitige Google Tag Manager.
Lassen Sie vor der Umstellung beide ein bis zwei Wochen parallel laufen und gleichen Sie jeweils mit Ihren tatsächlichen Verkäufen ab.
Serverseitiges Tracking mit eingebauter Compliance
FAQ: clientseitiges vs. serverseitiges Tracking
Nutzt serverseitiges Tracking Cookies?
Ja, auch serverseitiges Tracking nutzt Cookies – nur weniger Third-Party-Cookies. Die Daten erreichen die Anbieter von Server zu Server, sodass die Third-Party-Cookies, die deren Skripte früher im Browser gesetzt haben, weitgehend überflüssig werden. Ihre Website nutzt weiterhin First-Party-Cookies, um wiederkehrende Besucher zu erkennen, und ein Server kann sie selbst setzen. Weil Cookies also weiter im Spiel sind, gelten unverändert dieselben Anforderungen an die Einwilligung.
Können Adblocker serverseitiges Tracking blockieren?
Adblocker können serverseitiges Tracking blockieren, es passiert nur deutlich seltener. Der Browser sendet die Daten an eine Subdomain Ihrer eigenen Website statt an die Anbieter-Domains, auf die Adblocker achten – die Anfragen sehen damit nach First-Party-Traffic aus. Manche Adblocker sperren eine Tracking-Subdomain allerdings, sobald sie deren Zweck erkennen. Serverseitiges Tracking verringert den Datenverlust also, beseitigt ihn aber nicht.
Was ist ein Beispiel für serverseitiges Tracking?
Ein verbreitetes Beispiel für serverseitiges Tracking ist die Meta Conversions API. Statt sich allein auf das Meta Pixel im Browser zu verlassen, schickt ein Server die Conversion-Events – etwa einen Kauf – direkt an Meta. Meta empfiehlt, beides parallel zu betreiben und beide Datenströme zu deduplizieren, damit jeder Kauf nur einmal zählt.
Ist serverseitiges Tagging dasselbe wie serverseitiges Tracking?
Serverseitiges Tagging und serverseitiges Tracking meinen fast dasselbe, und die meisten verwenden die Begriffe synonym. Streng genommen beschreibt Tagging die Einrichtung: die Container und Trigger, die Events verarbeiten. Tracking beschreibt das Ziel: Nutzeraktionen und Conversions zu messen. Die Entscheidung zwischen serverseitigem und clientseitigem Tagging ist deshalb dieselbe wie die Entscheidung darüber, wie Sie tracken.