
Le tue campagne generano più dati che mai, ma quanti ne arrivano davvero nei report? Ad blocker, restrizioni dei browser e consensi mancanti intercettano ormai una fetta consistente dei segnali prima che raggiungano i tuoi strumenti di analisi o le piattaforme pubblicitarie. La risposta di cui parlano agenzie, commerciali delle piattaforme pubblicitarie e tutorial su GTM è il server-side tracking, e vale la pena capirlo bene.
Nel report IAB State of Data 2024, il 95% di chi prende decisioni su pubblicità e dati prevede un’ulteriore perdita di segnale, e più della metà si aspetta che attribuire i risultati delle campagne, misurare il ROI e tracciare le conversioni diventerà sempre più difficile.
Nella maggior parte dei team il danno si manifesta in silenzio: fai 100 vendite, ma la piattaforma pubblicitaria ne registra 60. Il budget si sposta verso campagne che sembrano rendere poco solo nei report, e il ciclo ricomincia.
Questa guida spiega cos’è il server-side tracking, come funziona, perché conviene e l’unica cosa che non cambia: i tuoi obblighi in materia di consenso.
In breve
Il server-side tracking, chiamato a volte anche server-side tagging, invia prima gli eventi del tuo sito a un server di tracciamento, che li ripulisce e li inoltra ai tuoi strumenti di analisi e alle piattaforme pubblicitarie. Il risultato: dati di conversione più accurati, pagine più veloci e più controllo su cosa riceve ogni vendor. Una cosa però non cambia: il tracking richiede sempre il consenso degli utenti, quindi la tua CMP resta al centro di tutta la configurazione.
Abbiamo raccolto tutto quello che leggi qui (e molto altro) in un white paper che puoi tenere con te.
Nessun modulo da compilare, nessun indirizzo da lasciare: scarichi subito il documento.
In questa guida:
- Cos’è il server-side tracking?
- Server-side tagging e server-side tracking: qual è la differenza?
- Client-side e server-side tracking: qual è la differenza?
- Come funziona il server-side tracking?
- I vantaggi del server-side tracking
- Ti serve davvero il server-side tracking?
- Il server-side tracking sostituisce il consenso ai cookie?
- Come configurare il server-side tracking, piattaforma per piattaforma
- Come configurare il server-side tracking: la checklist passo passo
- Gli errori più comuni nel server-side tracking
- FAQ sul server-side tracking
- Da dove iniziare
Cos’è il server-side tracking?
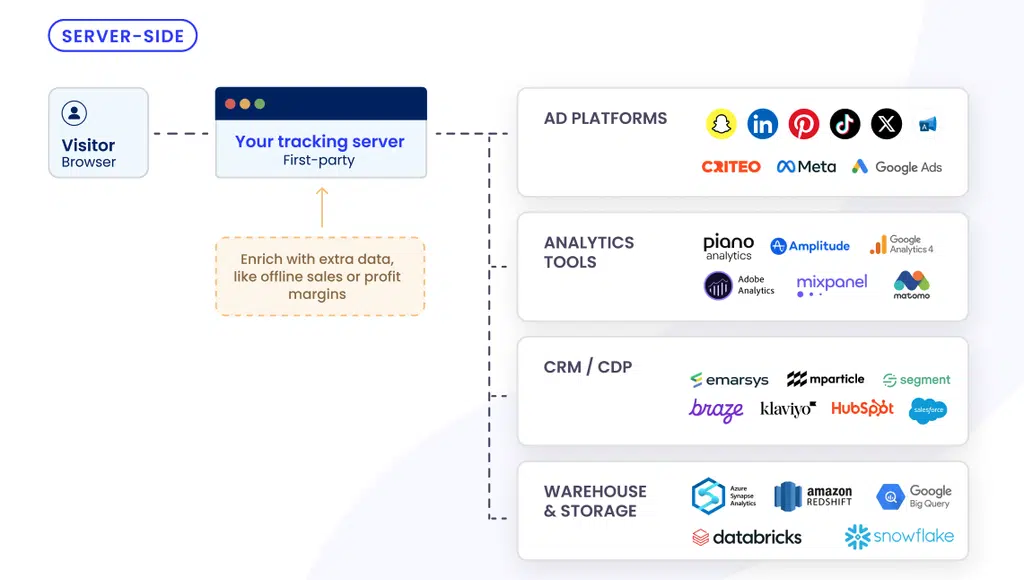
Il server-side tracking è un metodo di raccolta dei dati in cui il browser del visitatore invia gli eventi a un unico server di tracciamento, che li elabora e li inoltra ai tuoi strumenti di analisi e alle piattaforme pubblicitarie. Al posto di decine di script di terze parti che spediscono dati dal browser direttamente al proprio vendor, c’è un solo flusso che passa prima da un server.
L’ordine fa la differenza: prima raccogli i dati, poi decidi cosa serve davvero, li ripulisci e solo a quel punto invii quello che è utile e che ha il consenso. Più controllo per te, più privacy per chi visita il tuo sito.
Una precisazione subito: non devi costruirti un server. Quasi tutti i team marketing scelgono una soluzione gestita, in cui l’infrastruttura è a carico del fornitore e il tuo lavoro si svolge in una dashboard, dove gestisci i dati in entrata e decidi cosa esce verso ogni vendor.
Troverai spesso anche il termine «server-side tagging»: i due concetti sono vicini ma non coincidono, e nel prossimo paragrafo vediamo esattamente dove si separano.
Se ti serve un ripasso su come funziona il tracking in generale, parti dalla nostra guida su come funziona il tracciamento dei siti web.
Server-side tagging e server-side tracking: qual è la differenza?
La differenza è semplice: il tagging descrive la configurazione, il tracking il risultato. Il server-side tagging è l’architettura: i tuoi tag girano in un container su un server invece che nel browser del visitatore. Il server-side tracking è quello che ne ottieni: dati più puliti, meno script sulla pagina ed eventi che arrivano alle tue piattaforme anche quando un blocker li avrebbe fermati.
Nella pratica i due termini si usano come sinonimi e va benissimo così: la distinzione riguarda solo l’architettura.
Client-side e server-side tracking: qual è la differenza?
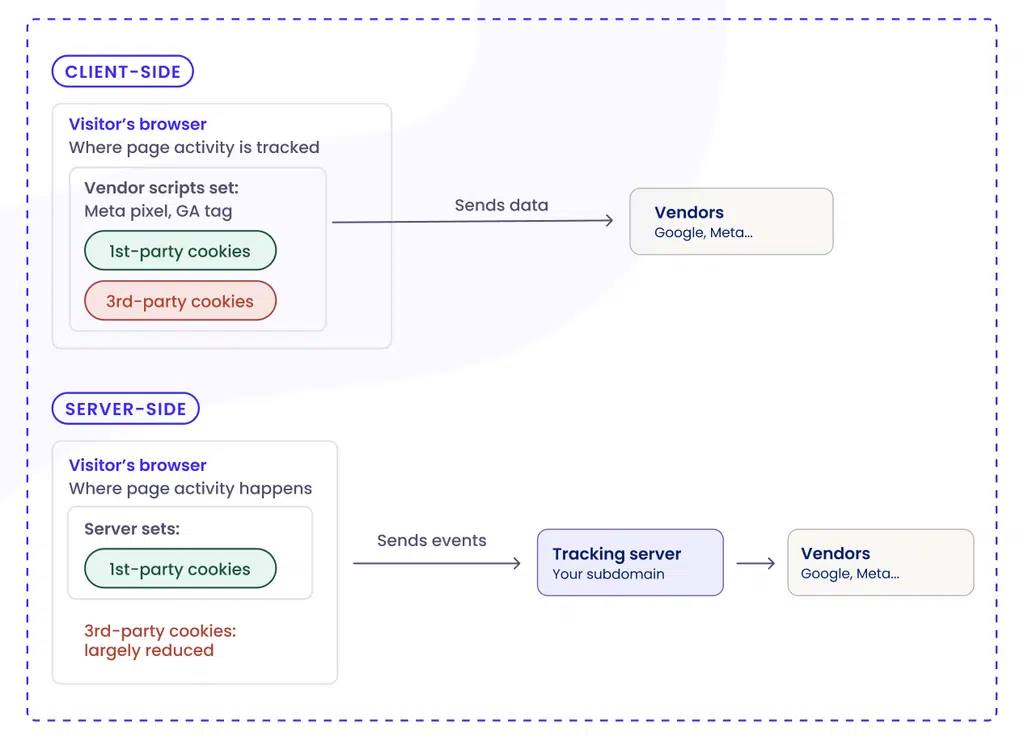
Che tu parli di tagging o di tracking, la differenza tra client-side e server-side sta in due cose: dove si raccolgono i dati e chi li controlla prima che arrivino ai vendor. Per un confronto completo, ecco come si confrontano client-side e server-side tracking.
| Client-side tracking | Server-side tracking | |
|---|---|---|
| Punto di raccolta dei dati | Il browser del visitatore | Un server di tracciamento |
| Controllo sui dati | Basso: gli script possono raccogliere più del dovuto | Alto: filtri e ripulisci i dati prima di inviarli ai vendor |
| Accuratezza | Indebolita da ad blocker e limiti dei browser | Regge ai blocker: gli eventi autorizzati sono accurati |
| Performance della pagina | Pesante: ogni script dei vendor si carica nel browser | Leggera: meno script sulla pagina |
| Configurazione | Un semplice snippet di codice | Infrastruttura server o una soluzione gestita |
| Costo | Di solito gratuito | Costi di hosting o abbonamento a uno strumento dedicato |
Come funziona il client-side tracking
Il client-side tracking è la configurazione classica: tag, pixel e script si caricano direttamente nel browser di chi visita il sito e ognuno manda i dati alla propria terza parte: Meta, Google Analytics, Google Ads e decine di altre.
Funzionava bene finché i browser collaboravano e quasi nessuno bloccava nulla. Oggi non è più così: l’Intelligent Tracking Prevention (ITP) di Safari e l’Enhanced Tracking Protection (ETP) di Firefox possono limitare il tracking per impostazione predefinita, e gli ad blocker sono ovunque.
Un equivoco da chiarire: nel 2025 Google ha confermato che Chrome non eliminerà i cookie di terze parti. Questo però non fa sparire il problema. Safari, Firefox ed Edge li limitano già, gli ad blocker continuano a diffondersi e le normative sulla privacy restano pienamente in vigore. La perdita di segnale è reale, a prescindere da cosa decide un singolo browser.
Come funziona invece il server-side tracking
Con il server-side tracking il browser invia un unico flusso di dati a un server di tracciamento, di solito attraverso un sottodominio che è tuo. Sono i vendor a ricevere i dati da quel server, non dal browser del visitatore. E siccome il browser dialoga solo con il tuo dominio, la richiesta somiglia a normale traffico first-party: così regge meglio di fronte agli ad blocker e ai limiti dei browser. Nei paragrafi che seguono vediamo esattamente come.
Come funziona il server-side tracking?
Il server-side tracking si articola in quattro passaggi:
- Il browser invia un evento a un server di tracciamento. Un visitatore clicca, si iscrive o compra, e l’evento arriva al server attraverso un sottodominio che è tuo.
- Il server riceve ed elabora l’evento. Di solito è un container server-side: un ambiente nel cloud che acquisisce gli eventi e applica le tue regole.
- Il server filtra e arricchisce i dati. Scarti quello che non ti serve, rimuovi o sottoponi ad hashing i dati personali e aggiungi contesto (per esempio il valore dell’ordine) prima che qualcosa esca.
- Il server inoltra dati puliti alle tue piattaforme. GA4, Meta, Google Ads e le altre ricevono i loro eventi da server a server.
Il ruolo del container server-side
L’implementazione più diffusa è il container server-side di Google Tag Manager, abbreviato in server-side GTM o sGTM. In Google Tag Manager una configurazione server-side usa due container: quello web sul tuo sito e quello server nel cloud. Il container server puoi ospitarlo tu oppure affidarlo a una soluzione gestita: in quel caso il fornitore lo fa girare al posto tuo e a te resta la configurazione, cioè il tuo tracking e le tue regole.
Perché conta avere un sottodominio first-party
Un ad blocker fa quello che dice il nome: impedisce agli annunci online di comparire. Col tempo, la maggior parte dei blocker ha esteso il raggio d’azione dagli annunci agli script di tracciamento che li accompagnano. In sostanza, gli ad blocker impediscono agli script di terze parti di raccogliere dati che gli utenti non hanno mai autorizzato.
Il server-side elimina del tutto quegli script dalla pagina. Quello che resta non è un tracking sfuggito al blocker, ma una misurazione first-party autorizzata dall’utente, che non è mai stata il bersaglio dei blocker. Il browser dialoga solo con il tuo sottodominio, quindi la richiesta somiglia a traffico first-party e non a uno strumento di tracciamento noto: è molto più difficile che finisca nella blocklist. Da lì il tuo server inoltra i dati ai vendor da server a server, dove gli ad blocker non hanno visibilità.*
*Alcuni ad blocker vanno oltre e bloccano direttamente un sottodominio di tracciamento quando capiscono che serve a raccogliere dati. Il server-side tracking rende la perdita di segnale molto meno probabile, non impossibile.
I vantaggi del server-side tracking
I vantaggi del server-side tagging si raccolgono in quattro aree, e si sommano tra loro.
Dati e attribuzione più accurati
È il vantaggio che quasi tutti i team marketing notano per primo. Visto che i dati di tracciamento passano da un server sul tuo dominio, il tuo tracking tiene meglio testa agli ad blocker e ai limiti dei browser. Un esempio: l’Intelligent Tracking Prevention di Safari limita a 7 giorni i cookie scritti via JavaScript nel browser. I cookie impostati da un server nella risposta HTTP possono durare di più, anche se Safari applica lo stesso limite di 7 giorni quando il sottodominio di tracciamento punta a una terza parte. Morale: conta molto come configuri il sottodominio.
Il server-side tracking fa emergere conversioni che avvenivano davvero ma non finivano nei report. E questo si vede subito sulla metrica che conta di più per chi investe in pubblicità: il ritorno sulla spesa pubblicitaria (ROAS).
Dati più ricchi
Siccome ogni evento passa prima da un server, puoi collegare quel server ai tuoi sistemi, per esempio il CRM o il database degli ordini, e aggiungere contesto prima di inoltrarlo. Si chiama arricchimento dei dati server-side, ed è esattamente il tipo di informazione per cui sono nate le regole di valore di conversione e il value-based bidding di Google.
Associa all’evento il margine di un acquisto o il lifetime value del cliente e puoi dire all’algoritmo di inseguire il profitto e i clienti di valore, non solo il numero di vendite.
Pagine più veloci
Ogni script di tracciamento aggiunge peso che il browser deve scaricare ed eseguire mentre la pagina prova a caricarsi, e questo rallenta tutto, soprattutto da mobile.
Il server-side tracking sposta gran parte di quel lavoro fuori dal browser. Meno script sulla pagina significa caricamenti più rapidi, Core Web Vitals migliori e SEO più forte. E la velocità si traduce anche in fatturato: un sito che carica in 1 secondo converte fino a 3 volte meglio di uno che ne impiega 5.
Più controllo sulla conformità
Far passare ogni evento da un unico server di tracciamento trasforma la governance dei dati in qualcosa che applichi davvero. Il server è l’unico punto di controllo attraversato da tutti gli eventi, quindi è lì che stabilisci le regole:
- Invia solo quello che serve. La minimizzazione dei dati è uno dei principi cardine del Regolamento generale sulla protezione dei dati (GDPR). Il server-side la rende concreta: inoltri i campi che servono a un vendor per registrare una conversione e scarti il resto.
- Applica l’hashing ai dati personali o rimuovili. Per ogni destinazione decidi tu cosa esce: eliminare il campo, applicargli l’hashing o lasciarlo passare. Attenzione: l’hashing è pseudonimizzazione, non anonimizzazione. Un’email sottoposta ad hashing resta un dato personale e ha bisogno di una base giuridica. L’hashing limita comunque quello che un vendor può fare con quel campo, al di là dell’associazione che gli serve. Una nota pratica: ogni vendor fissa i requisiti minimi che un evento deve rispettare per essere accettato e associato, quindi quanto puoi togliere dipende dalla destinazione.
- Blocca le fughe di dati all’origine. Siccome il passaggio avviene da server a server, gli script di terze parti non possono setacciare il browser alla ricerca di informazioni che non sono autorizzati a raccogliere.
- Conserva una traccia di tutto. Registra ogni flusso di dati e costruisci il tipo di documentazione che le autorità si aspettano sempre più spesso.
Dati first-party: il vero patrimonio che stai costruendo
Tutto questo porta a un cambiamento strategico: costruisci un patrimonio di dati che è tuo, invece di prendere in prestito segnali da terze parti che stanno sparendo. I dati first-party sono le informazioni che raccogli direttamente attraverso i tuoi canali, più affidabili e più rispettosi della privacy rispetto ai dati di terze parti.
Il mercato si è già mosso: il 71% tra brand, agenzie ed editori sta ampliando i propri dataset first-party, e secondo BCG le aziende che collegano tra loro le fonti di dati first-party generano 1,5 volte il fatturato incrementale da un singolo posizionamento pubblicitario e raddoppiano il miglioramento in efficienza dei costi.
C’è un però: i dati first-party funzionano solo se riesci a raccoglierli in modo lecito, ad attivarli su tutti i tuoi strumenti e a usarli. Il consenso decide tutte e tre le cose: se sbagli il sistema di raccolta del consenso, ogni strumento a valle eredita il problema.
Come spiega Andreea Mandeal, CMO di iubenda, sulle pagine dello IAB Tech Lab, senza un sistema di consenso affidabile i dati first-party «non possono essere usati con sicurezza da nessun team a valle».
Ti serve davvero il server-side tracking?
Prima di investire nel server-side tracking, fai una verifica veloce con le domande qui sotto. Chiediti:
- Investi in pubblicità e ti servono dati di conversione accurati per ottimizzare le campagne?
- Confronta le conversioni che riporta la tua piattaforma pubblicitaria con quello che hai venduto davvero: i numeri coincidono?
- L’attribuzione accurata guida davvero le tue decisioni di budget, o resta solo un dato nei report?
- Stai costruendo una strategia sui dati first-party che devi poter attivare con affidabilità?
- Raccogli già i dati attraverso un vero sistema di consenso?
→ Se hai risposto sì a più di una, probabilmente il server-side tracking vale l’investimento già adesso. Il segnale da tenere più d’occhio è la distanza tra conversioni registrate e conversioni reali: è lì che si nasconde il budget sprecato.
→ Potrebbe non essere il momento giusto se le tue esigenze di analisi sono di base e non investi in pubblicità, oppure se ti mancano le risorse tecniche e non sei pronto a usare una soluzione gestita che si occupa della parte più complessa al posto tuo. Lo stesso vale se non raccogli ancora i dati attraverso un sistema di consenso.
Il server-side tracking sostituisce il consenso ai cookie?
No, il server-side tracking non sostituisce il consenso ai cookie. Cambia dove si trattano i dati, non il fatto che ti serva un’autorizzazione per trattarli. Se il tuo tracking richiedeva il consenso quando girava nel browser, lo richiede anche quando gira su un server. È anche il mito più duro a morire su server-side tracking e GDPR, quindi vale la pena smontarlo.
Perché anche il server-side tracking richiede una base giuridica valida ai sensi del GDPR
Il GDPR richiede una base giuridica per il trattamento dei dati personali (articolo 6) e, per quasi tutto il tracking di marketing, quella base è il consenso. La Direttiva ePrivacy (la cosiddetta «cookie law») aggiunge una regola sua: salvare o leggere identificatori sul dispositivo di una persona richiede in genere il consenso, a prescindere da dove viaggiano i dati dopo.
Spostare il tracking su un server cambia l’architettura, non gli obblighi:
- Una piattaforma di gestione del consenso (CMP) resta il tassello che raccoglie la scelta di ogni visitatore.
- La tua gestione del consenso ai cookie deve passare quella scelta al server di tracciamento, in modo che inoltri solo i dati autorizzati.
- Anche la tua privacy e cookie policy deve rispecchiare cosa raccogli e chi lo riceve: il Generatore di Privacy Policy tiene la documentazione allineata alla configurazione reale.
E siccome il trattamento server-side è meno visibile agli utenti rispetto agli script nel browser, la trasparenza conta di più, non di meno.
Nella pratica si regge su tre cose:
- un cookie banner che spiega il trattamento server-side e perché ogni vendor riceve i dati,
- il consenso trasmesso a ogni partner insieme a ciascun evento,
- un registro delle prove di consenso, per poter dimostrare chi ha acconsentito a cosa.
Una difficoltà nota da mettere in conto: alla primissima interazione di un visitatore il suo stato di consenso non è ancora noto. Far dialogare in modo pulito il sistema di consenso e il server proprio in quel momento richiede una configurazione attenta.
Un modo di fare tracking più attento alla privacy
Il server-side è un modo più rispettoso di trattare i dati delle persone: tutto passa da un unico punto di controllo prima di raggiungere chiunque altro, e cambia così anche ciò a cui esponi i tuoi visitatori.
La stessa architettura che ti restituisce il segnale ti dà anche più controllo sui dati: quelli autorizzati sono trattati con più attenzione, quelli senza consenso non partono proprio.
Un’altra soluzione attenta alla privacy per recuperare dati di tracking è Google Consent Mode, che dice ai tag di Google come comportarsi in base alla scelta fatta da ogni utente sul tuo cookie banner. Se l’utente accetta, il tracking funziona normalmente. Se rifiuta, la configurazione avanzata invia ping limitati e senza cookie, che colmano il vuoto con una modellazione aggregata invece che con il tracciamento individuale.
- Il server-side tracking recupera la maggior parte possibile dei dati autorizzati, quelli che rischiavano di perdersi.
- Consent Mode copre il resto, colmando il vuoto lasciato da chi rifiuta.
Insieme ti danno un quadro più completo e rispettoso della privacy sulle performance, ed entrambi dipendono dalla tua CMP per raccogliere un consenso valido in partenza.
Come configurare il server-side tracking, piattaforma per piattaforma
Il server-side tagging funziona in modo un po’ diverso su ogni piattaforma. GA4, Meta, Google Ads, Shopify e WordPress hanno ciascuno un proprio meccanismo server-side, ma lo schema è sempre lo stesso: il server di tracciamento invia gli eventi direttamente ai server della piattaforma, senza passare dal browser.
| Piattaforma | Meccanismo server-side | Cosa ti serve |
|---|---|---|
| GA4 | Container server-side di GTM | Un container sGTM (self-hosted o gestito) con un tag GA4 |
| Meta (Facebook e Instagram) | Conversions API (CAPI) | Una connessione CAPI, di solito tramite sGTM o un’integrazione della piattaforma |
| Google Ads | Conversioni avanzate e tracciamento delle conversioni server-side | Tag di conversione instradati attraverso lo stesso container server |
| TikTok, LinkedIn, Microsoft Ads | TikTok Events API, LinkedIn Conversions API, Microsoft Ads UET | L’API server-to-server della piattaforma, alimentata dal server di tracciamento |
| Shopify, WooCommerce, WordPress | sGTM o integrazioni della piattaforma | Una connessione tra il tuo negozio online o sito e il container server |
Qualche nota per chiarire cosa aspettarsi:
- GA4 e Google Ads usano lo stesso container server: una volta configurato il primo, il secondo richiede pochissimo lavoro in più.
- Meta, TikTok, LinkedIn e Microsoft Ads hanno ciascuno il proprio modo di ricevere eventi da un server (Meta la chiama Conversions API), ma l’idea è sempre la stessa: gli eventi arrivano direttamente alla piattaforma, senza passare dal browser.
- Shopify e WooCommerce si collegano tramite integrazioni, così è il tuo negozio online a registrare gli acquisti, non il browser di chi compra.
Come configurare il server-side tracking: la checklist passo passo
Ecco come si presenta di solito l’implementazione, qualunque strumento tu scelga:
- Prepara il livello server. Crea un server di tracciamento nel cloud, nella maggior parte dei casi un container sGTM. Puoi ospitarlo tu o affidarti a una soluzione gestita che lo fa girare al posto tuo (molto più semplice).
- Puntaci un sottodominio personalizzato. Crea un sottodominio sul tuo dominio (per esempio
analytics.tuodominio.com) e indirizzalo al server con un record DNS. - Collega la tua CMP. Porta i segnali di consenso nel server, così niente parte prima che il visitatore abbia scelto. È il passaggio che tiene onesta tutta la catena.
- Decidi cosa può passare. Definisci cosa filtrare, arricchire o bloccare prima che i dati arrivino a un vendor.
- Collega le destinazioni. Manda gli eventi alle piattaforme che usi: GA4, Meta CAPI, Google Ads e le altre.
- Aggiorna la documentazione privacy. Verifica che la privacy e cookie policy rispecchino i flussi di dati e i vendor che li ricevono.
- Fai girare le due configurazioni in parallelo. Tieni attivo il client-side tracking per una o due settimane e confronta i numeri. Se coincidono, puoi fidarti della nuova catena.
- Monitora e aggiorna. Controlla segnali di consenso, flussi di dati e cosa riceve ogni vendor, e continua a tenere d’occhio la situazione man mano che piattaforme e regole cambiano.
Metti in conto anche il team: il marketing si occupa della configurazione del tracking e degli obiettivi, uno sviluppatore del sottodominio e del routing. Con una soluzione gestita il carico tecnico si riduce parecchio.
Gli errori più comuni nel server-side tracking
Una configurazione server-side può fare molto, ed è proprio per questo che è facile sbagliarla. Gli errori più frequenti:
- Conversioni duplicate. Tenere attivi insieme un pixel nel browser e una connessione server-side senza deduplicazione conta lo stesso acquisto due volte, e numeri gonfiati ingannano quanto quelli mancanti.
- Dati personali non sottoposti ad hashing nei payload del server. Più accesso ai dati significa più responsabilità: applica l’hashing agli identificatori o rimuovili prima che gli eventi lascino il server.
- Un sottodominio first-party configurato male. Se il routing DNS è sbagliato perdi la connessione e rischi di accorgertene solo dopo settimane.
- Ignorare lo stato del consenso nei payload del server. Il server deve ricevere e rispettare la scelta di ogni visitatore sul tracking, anche nella prima visita, che è la più delicata. Inoltrare da un server eventi senza consenso resta tracking non autorizzato e non è conforme.
- Trattare il server-side come se fosse invisibile. Gli utenti non possono vedere il trattamento server-side come ispezionano i cookie, quindi spiegalo apertamente nel cookie banner e nella documentazione privacy. Quando la visibilità cala, la trasparenza conta ancora di più.
Da dove iniziare
Il server-side tracking ti restituisce il segnale che stai perdendo e più controllo su cosa esce dal tuo sito. Ma i dati che recupera sono utilizzabili solo se il consenso viaggia insieme a loro. Misurare con precisione e rispettare la privacy delle persone non sono obiettivi in conflitto: nelle configurazioni migliori sono la stessa cosa.
Server-side tracking con la conformità già inclusa
Configura facilmente anche la conformità
FAQ sul server-side tracking
Il server-side tracking è conforme al GDPR?
Il server-side tracking aiuta a gestire la conformità al GDPR, ma da solo non la garantisce. Cambia dove si trattano i dati, non il fatto che il GDPR si applichi. Trattare dati personali richiede una base giuridica ovunque avvenga, quindi i tuoi obblighi restano gli stessi. L’unica vera differenza: il server ti permette di filtrare cosa esce, e i dati che non possono più essere ricondotti a una persona (davvero anonimizzati) non sono dati personali ai sensi del GDPR.
Il server-side tracking richiede il consenso ai cookie?
Sì. L’obbligo di consenso scatta nel momento in cui qualcosa legge o scrive sul dispositivo di un visitatore, non in base a dove viaggiano poi i dati. Se uno strumento di tracciamento richiedeva il consenso nel browser, lo richiede anche nella versione server-side. La tua CMP deve passare la scelta di ogni visitatore al server di tracciamento, in modo che inoltri solo i dati autorizzati.
Il server-side tagging è legale?
Sì, il server-side tagging è legale se l’infrastruttura di raccolta del consenso è configurata bene. A rendere lecito il tracking non è il posto in cui gira, ma il fatto che tu abbia una base giuridica. Spostare i tag su un server cambia l’architettura, non gli obblighi: se uno strumento di tracciamento richiedeva il consenso nel browser, lo richiede anche lato server. Il consiglio è di usare una piattaforma di gestione del consenso come iubenda, che passa la scelta di ogni visitatore al server di tracciamento, in modo che il server inoltri solo i dati autorizzati.
È difficile configurare il server-side tracking?
Richiede un lavoro di configurazione reale, e quanto sia impegnativo dipende dalla strada che scegli. Farlo da zero è complesso e richiede tempo di sviluppo: container, sottodominio, server, routing e poi la manutenzione nel tempo. Con una soluzione gestita quasi tutta la parte tecnica sparisce: il server lo fa girare il fornitore e a te resta la dashboard, dove decidi cosa raccogliere, cosa filtrare e cosa inoltrare.
Serve per forza Google Tag Manager per il server-side tagging?
No, Google Tag Manager non è obbligatorio, anche se il server-side GTM è la strada più battuta. Va bene qualsiasi configurazione che riceva eventi su un server e li inoltri ai tuoi vendor. sGTM è popolare perché la configurazione è gratuita, funziona da subito con GA4 e Google Ads e ha alle spalle la documentazione più ampia.
Quanto costa il server-side tagging?
Il costo del server-side tagging nasce dall’hosting cloud del container server, fatturato in base al traffico che ci fai passare. Se invece di ospitarlo tu scegli un abbonamento a una soluzione gestita, quella voce rientra nel canone. Lo stesso vale per il tempo di configurazione e manutenzione, la voce che i team sottovalutano più spesso. In sintesi: hosting, configurazione e manutenzione, con il tempo del tuo team (gli sviluppatori, in pratica) da mettere in conto.
Il server-side tracking elimina del tutto i cookie?
No. Il server-side tracking riduce quanto il tuo tracking dipende dai cookie, ma non li elimina. L’inoltro ai vendor avviene da server a server, quindi i cookie di terze parti che gli script dei vendor rilasciavano nel browser diventano in gran parte inutili. Il tuo sito continua di solito a usare cookie di prima parte per riconoscere chi torna, ora impostati dal server e più duraturi. Gli obblighi di consenso per quei cookie restano identici.
Client-side o server-side tracking: quale conviene?
Scegli il server-side tracking se investi in pubblicità, se ti servono dati di conversione accurati o se stai costruendo una strategia sui dati first-party. Il client-side può bastare se le tue esigenze sono di base e non fai campagne pubblicitarie.