
Tus campañas generan más datos que nunca, pero ¿llegan a tus informes? Los bloqueadores de anuncios, las restricciones de los navegadores y las lagunas de consentimiento interceptan ya una parte nada despreciable de las señales antes de que lleguen a tu analítica o a tus plataformas publicitarias. Agencias, comerciales de publicidad y tutoriales de GTM te hablan del tracking del lado del servidor como respuesta, y merece la pena entenderlo bien.
Según el informe IAB State of Data 2024, el 95 % de los responsables de publicidad y datos espera que la pérdida de señal continúe, y más de la mitad prevé que será más difícil atribuir el rendimiento de las campañas, medir el ROI y hacer seguimiento de las conversiones.
En la mayoría de los equipos el daño pasa desapercibido: cierras 100 ventas y tu plataforma publicitaria solo registra 60. El presupuesto se reparte en función de campañas que solo aparentan rendir mal, y la rueda vuelve a empezar.
En esta guía verás qué es el tracking del lado del servidor, cómo funciona, por qué merece la pena y lo único que no cambia: tus obligaciones en materia de consentimiento.
En resumen
El tracking del lado del servidor, también llamado a veces tagging del lado del servidor, envía los eventos de tu web a un servidor de tracking que los depura y los reenvía a tus herramientas de analítica y a tus plataformas publicitarias. Ganas precisión en los datos de conversión, páginas más rápidas y más control sobre lo que recibe cada proveedor. Lo que no cambia: el tracking sigue necesitando el consentimiento del usuario, así que tu plataforma de gestión del consentimiento sigue siendo el centro de todo el sistema.
Hemos reunido todo lo de este artículo (¡y más!) en un white paper que puedes guardar.
Sin formularios ni correos: solo el PDF.
En esta guía:
- ¿Qué es el tracking del lado del servidor?
- Tagging y tracking del lado del servidor: ¿en qué se diferencian?
- Tracking del lado del cliente y del lado del servidor: ¿en qué se diferencian?
- ¿Cómo funciona el tracking del lado del servidor?
- Ventajas del tracking del lado del servidor
- ¿Necesitas tracking del lado del servidor?
- ¿El tracking del lado del servidor sustituye al consentimiento para cookies?
- Configuración del tracking del lado del servidor, plataforma a plataforma
- Cómo configurar el tracking del lado del servidor: lista de comprobación paso a paso
- Errores habituales del tracking del lado del servidor
- FAQ: tracking del lado del servidor
- Por dónde empezar
¿Qué es el tracking del lado del servidor?
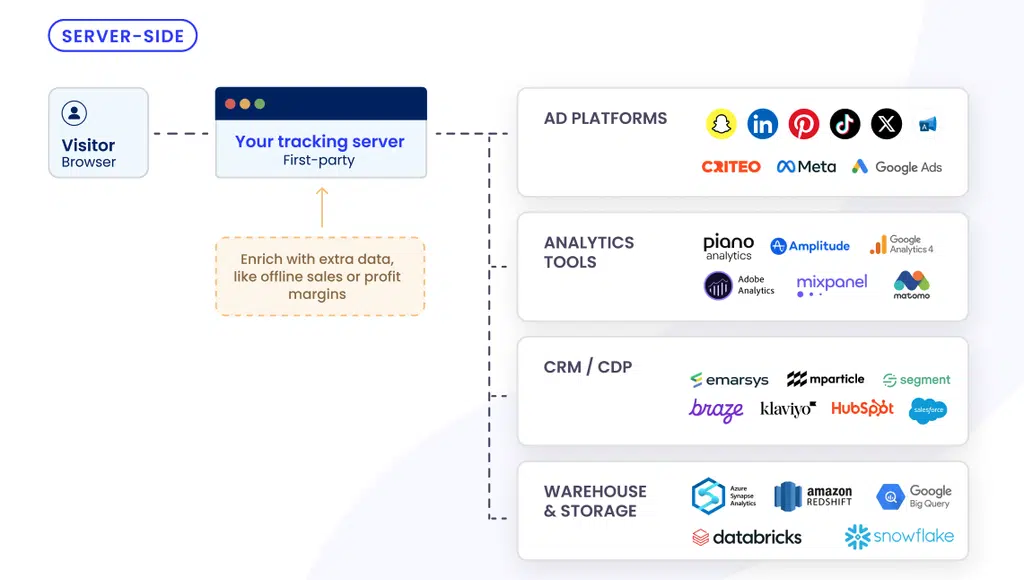
El tracking del lado del servidor es un método de recogida de datos web en el que el navegador del visitante envía los eventos a un único servidor de tracking, que los procesa y los reenvía a tus herramientas de analítica y a tus plataformas publicitarias. En lugar de decenas de scripts de terceros que envían cada uno sus datos directamente desde el navegador a su proveedor, un solo flujo pasa primero por un servidor.
El orden importa: primero recoges los datos, decides qué te sirve, los depuras y solo entonces envías lo necesario y lo consentido. Más control para ti, más privacidad para tus visitantes.
Aclaremos algo desde ya: esto no significa montar un servidor. La mayoría de los equipos de marketing recurre a una solución gestionada, en la que el proveedor se encarga de la infraestructura y tú trabajas desde un dashboard: gestionas los datos que entran y controlas qué sale hacia cada proveedor.
También verás el término «tagging del lado del servidor». Son conceptos cercanos, pero no idénticos: en el siguiente apartado vemos dónde está la diferencia.
Si quieres repasar cómo funciona el tracking en general, empieza por nuestra guía sobre cómo funciona el tracking web.
Tagging y tracking del lado del servidor: ¿en qué se diferencian?
La diferencia está en que el tagging describe la configuración y el tracking, el resultado. El tagging del lado del servidor es la arquitectura: tus etiquetas se ejecutan en un contenedor alojado en un servidor y no en el navegador del visitante. El tracking del lado del servidor es lo que obtienes a cambio: datos más limpios, menos scripts en la página y eventos que llegan a tus plataformas incluso cuando un bloqueador los habría detenido.
La mayoría de los profesionales del marketing usa los dos términos indistintamente y, por lo general, no pasa nada: la distinción exacta es arquitectónica.
Tracking del lado del cliente y del lado del servidor: ¿en qué se diferencian?
Lo llames tagging o tracking, la diferencia entre el lado del cliente y el lado del servidor está en dónde se recogen los datos y quién los controla antes de que lleguen a los proveedores. Para una comparativa completa, mira en qué se diferencian el tracking del lado del cliente y el del lado del servidor.
| Tracking del lado del cliente | Tracking del lado del servidor | |
|---|---|---|
| Punto de recogida de datos | El navegador del visitante | Un servidor de tracking |
| Control de los datos | Bajo: los scripts pueden recoger más de lo que deberían | Alto: filtras y depuras los datos antes de enviarlos a los proveedores |
| Precisión | Debilitada por los bloqueadores de anuncios y los límites de los navegadores | Aguanta frente a los bloqueadores; los eventos consentidos son precisos |
| Rendimiento de la página | Pesado: cada script de proveedor se carga en el navegador | Ligero: menos scripts en la página |
| Configuración | Un simple fragmento de código | Infraestructura de servidor o una solución gestionada |
| Coste | Normalmente gratis | Costes de alojamiento o una suscripción a una herramienta específica |
Cómo funciona el tracking del lado del cliente
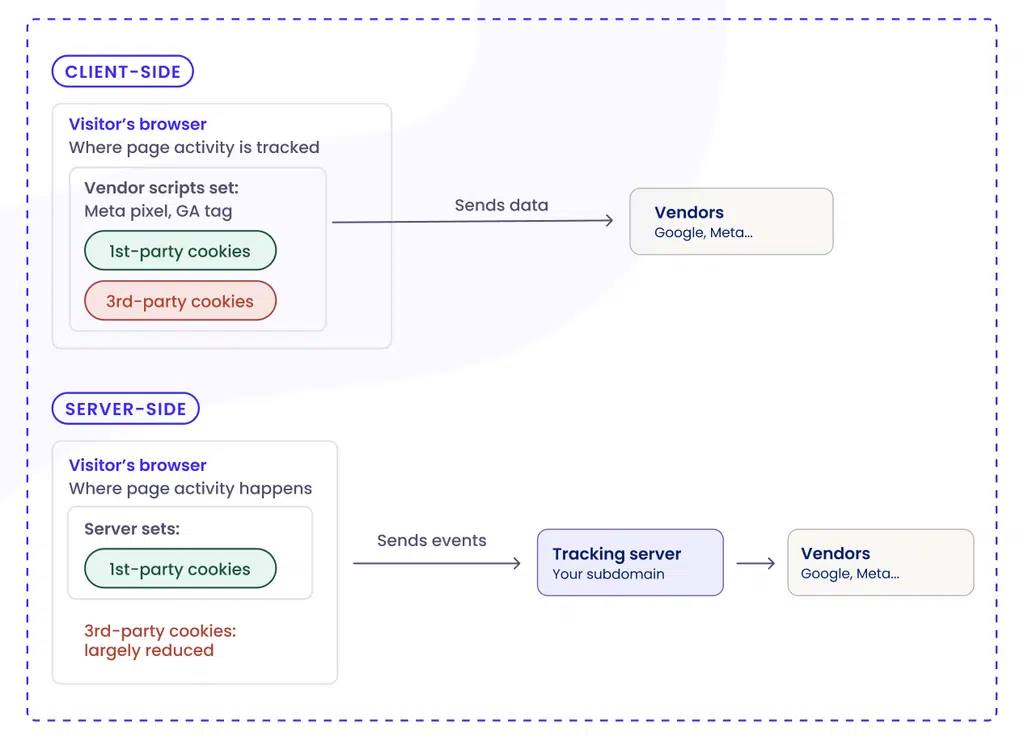
El tracking del lado del cliente es el planteamiento clásico: las etiquetas, los píxeles y los scripts se cargan directamente en el navegador de tus visitantes, y cada uno envía los datos a su propio tercero: Meta, Google Analytics, Google Ads y decenas más.
Funcionaba bien cuando los navegadores colaboraban y casi nadie bloqueaba nada. Ya no es el caso: la Intelligent Tracking Prevention (ITP) de Safari y la Enhanced Tracking Protection (ETP) de Firefox pueden restringir el tracking por defecto, y los bloqueadores de anuncios están en todas partes.
Conviene aclarar un malentendido muy extendido: en 2025 Google confirmó que Chrome no va a eliminar las cookies de terceros después de todo. Eso no quiere decir que el problema haya desaparecido. Safari, Firefox y Edge ya las restringen, los bloqueadores de anuncios siguen ganando terreno y la normativa de privacidad sigue plenamente vigente. La pérdida de señal es real, decida lo que decida un navegador concreto.
Y cómo funciona el del lado del servidor
Con el tracking del lado del servidor, el navegador envía un único flujo de datos a un servidor de tracking, normalmente a través de un subdominio tuyo. Los proveedores reciben sus datos de ese servidor, no del navegador del visitante. Como el navegador solo habla con tu dominio, la petición parece tráfico propio y aguanta mejor frente a los bloqueadores de anuncios y a los límites de los navegadores. En los apartados siguientes vemos exactamente cómo ocurre.
¿Cómo funciona el tracking del lado del servidor?
El tracking del lado del servidor sigue cuatro pasos:
- El navegador envía un evento a un servidor de tracking. Un visitante hace clic, se registra o compra, y el evento llega al servidor a través de un subdominio tuyo.
- El servidor recibe el evento y lo procesa. Normalmente es un contenedor del lado del servidor: un entorno alojado en la nube que ingiere eventos y aplica tus reglas.
- El servidor filtra y enriquece los datos. Descartas lo que no necesitas, aplicas un hash a los datos personales o los eliminas y añades contexto (como el valor del pedido) antes de que salga nada.
- El servidor reenvía datos limpios a tus plataformas. GA4, Meta, Google Ads y el resto reciben sus eventos de servidor a servidor.
El papel del contenedor del lado del servidor
La implementación más habitual es un contenedor de Google Tag Manager del lado del servidor, que se abrevia habitualmente como GTM del lado del servidor o sGTM. En Google Tag Manager, estas configuraciones usan dos contenedores: el contenedor web en tu sitio y el contenedor de servidor en la nube. Ese contenedor de servidor puedes alojarlo tú o recurrir a una solución gestionada en la que el proveedor lo ejecuta por ti y tú mantienes la configuración: tu propia configuración de tracking y tus reglas.
Por qué importa tener un subdominio propio
En esencia, un bloqueador de anuncios hace lo que su nombre indica: impedir que aparezcan anuncios online. Con el tiempo, la mayoría amplió su alcance de los anuncios a los scripts de tracking que vienen con ellos. En el fondo, los bloqueadores de anuncios impiden que los scripts de terceros recojan datos que el usuario nunca aceptó ceder.
El lado del servidor elimina esos scripts de la página por completo. Lo que sobrevive no es tracking que haya burlado al bloqueador, sino medición propia que el usuario ha consentido, que nunca fue el objetivo del bloqueador. El navegador solo habla con tu subdominio, así que la petición parece tráfico propio y no un rastreador conocido, y es menos probable que active la lista de bloqueo. Después tu servidor reenvía los datos a los proveedores de servidor a servidor, donde los bloqueadores de anuncios no tienen visibilidad.*
*Algunos bloqueadores van más allá y bloquean directamente un subdominio de tracking en cuanto identifican que sirve para recoger datos. El tracking del lado del servidor hace que la pérdida de señal sea mucho menos probable, pero no imposible.
Ventajas del tracking del lado del servidor
Las ventajas del tagging del lado del servidor se agrupan en cuatro áreas, y se refuerzan entre sí.
Datos y atribución más precisos
Es la ventaja que casi todos los equipos de marketing notan primero. Como puedes recibir los datos de tracking en un servidor de tu propio dominio, tu tracking aguanta mejor frente a los bloqueadores de anuncios y a los límites de los navegadores. Por ejemplo, la Intelligent Tracking Prevention de Safari limita a 7 días las cookies escritas por JavaScript en el navegador. Las cookies que escribe un servidor en la respuesta HTTP pueden durar más, aunque Safari también las limita a 7 días cuando el subdominio de tracking resuelve a un tercero. Es decir: cómo esté configurado el subdominio marca la diferencia.
El tracking del lado del servidor saca a la luz conversiones que estaban ocurriendo de verdad pero que no llegaban a los informes. Y eso afecta a la métrica que más les importa a los anunciantes: el retorno de la inversión publicitaria (ROAS).
Datos más completos
Como cada evento pasa primero por un servidor, puedes conectarlo con tus propios sistemas, como tu CRM o tu base de datos de pedidos, y añadir contexto antes de reenviarlo. Es lo que se llama enriquecimiento de datos del lado del servidor, y las pujas basadas en valor y las reglas de valor de conversión de Google están pensadas justo para este tipo de información.
Adjunta al evento el margen de beneficio de una compra o el valor del ciclo de vida del cliente y podrás decirle al algoritmo que vaya a por el beneficio y los clientes de más valor, no solo por el volumen de ventas.
Páginas más rápidas
Cada script de tracking añade peso que el navegador tiene que descargar y ejecutar mientras la página intenta renderizarse, y eso la ralentiza, sobre todo en móvil.
El tracking del lado del servidor saca casi todo ese trabajo del navegador. Menos scripts en la página significa cargas más rápidas, mejores Core Web Vitals y más fuerza en SEO. Y la velocidad también se traduce en ingresos: una web que carga en 1 segundo convierte hasta 3 veces mejor que otra que tarda 5.
Una base de cumplimiento más sólida
Hacer pasar cada evento por un único servidor de tracking convierte la gobernanza de datos en algo que de verdad puedes aplicar. El servidor es el único punto de control por el que pasa todo evento, así que es ahí donde fijas las reglas:
- Envía solo lo que necesitas. La minimización de datos es un principio básico del Reglamento General de Protección de Datos (RGPD). El lado del servidor lo hace viable: reenvías los campos que el proveedor necesita para registrar una conversión y descartas el resto.
- Aplica un hash a los datos personales o elimínalos. Para cada destino decides qué sale: eliminas el campo, le aplicas un hash o lo dejas pasar. Atención: el hash es seudonimización, no anonimización. Un correo hasheado sigue siendo un dato personal y necesita una base jurídica. Aun así, el hash limita lo que un proveedor puede hacer con el campo más allá del cruce que necesita. Un apunte práctico: cada proveedor fija unos requisitos mínimos de contenido para aceptar y cruzar un evento, así que cuánto puedes eliminar depende del destino.
- Corta las fugas de datos en origen. Como el traspaso es de servidor a servidor, los scripts de terceros no pueden rastrear el navegador en busca de información que no están autorizados a recoger.
- Mantén un registro de auditoría. Registra cada flujo de datos y tendrás el historial que los reguladores piden cada vez más.
Datos propios: el activo que de verdad estás construyendo
Todo lo anterior apunta a un mismo cambio estratégico: construir un activo de datos que es tuyo en lugar de alquilar señales a terceros que están desapareciendo. Los datos propios son la información que recoges directamente por tus propios canales, y son más fiables y más respetuosos con la privacidad que los datos de terceros.
El sector ya se ha movido: el 71 % de las marcas, agencias y editores está ampliando sus conjuntos de datos propios, y BCG comprobó que las empresas que conectan sus fuentes de datos propios generan 1,5 veces más ingresos incrementales con un mismo emplazamiento publicitario, y el doble de mejora en eficiencia de costes.
El matiz: los datos propios solo funcionan si puedes recogerlos de forma lícita, activarlos en todas tus herramientas y usarlos. El consentimiento decide las tres cosas: si fallas en la capa de consentimiento, todas las herramientas que vienen después heredan ese fallo.
Como lo expresa Andreea Mandeal, CMO de iubenda, para el IAB Tech Lab, sin un marco de consentimiento fiable los datos propios «no los puede usar con confianza ningún equipo de la cadena».
¿Necesitas tracking del lado del servidor?
Antes de invertir en tracking del lado del servidor, repasa rápidamente las preguntas de abajo. Pregúntate:
- ¿Inviertes en publicidad y necesitas datos de conversión precisos para optimizar tus campañas?
- Compara las conversiones que te atribuye tu plataforma publicitaria con lo que has vendido de verdad. ¿Cuadran las cifras?
- ¿La atribución precisa decide de verdad tu presupuesto, o solo alimenta informes?
- ¿Estás construyendo una estrategia de datos propios que necesitas activar con fiabilidad?
- ¿Ya recoges datos a través de una capa de consentimiento sólida?
→ Si has respondido que sí a varias, probablemente ya te compense invertir en tracking del lado del servidor. La señal que más conviene vigilar es la diferencia entre las conversiones que recogen tus informes y las reales, porque ahí es donde se esconde el presupuesto desperdiciado.
→ Puede que no sea el momento si tus necesidades de analítica son básicas y no inviertes en publicidad, o si no tienes recursos técnicos y no te planteas una solución gestionada que se encargue de la parte más compleja. Lo mismo si todavía no recoges datos a través de una capa de consentimiento.
¿El tracking del lado del servidor sustituye al consentimiento para cookies?
No, el tracking del lado del servidor no sustituye al consentimiento para cookies. Cambia dónde se tratan tus datos, no si necesitas permiso para tratarlos. Si tu tracking requería consentimiento cuando se ejecutaba en el navegador, lo sigue requiriendo cuando se ejecuta en un servidor. Además, es el mito más persistente sobre el tracking del lado del servidor y el RGPD, así que merece la pena desmontarlo.
Por qué el tracking del lado del servidor sigue necesitando una base jurídica válida según el RGPD
El RGPD exige una base jurídica para tratar datos personales (artículo 6) y, en la mayor parte del tracking de marketing, esa base es el consentimiento. La Directiva ePrivacy de la UE (la «ley de cookies») añade su propia regla: almacenar identificadores en el dispositivo del usuario o acceder a ellos exige consentimiento, viaje después el dato a donde viaje.
Llevar el tracking a un servidor cambia la arquitectura, no las obligaciones:
- Una plataforma de gestión del consentimiento (CMP) sigue siendo la pieza que recoge la elección de cada visitante.
- Tu configuración de gestión del consentimiento de cookies tiene que pasar esa elección al servidor de tracking para que solo reenvíe datos consentidos.
- Tu política de privacidad y de cookies también tiene que reflejar qué recoges y quién lo recibe; un Generador de Políticas de Privacidad mantiene esa documentación alineada con tu configuración real.
Como el tratamiento del lado del servidor es menos visible para el usuario que los scripts del navegador, la transparencia importa más, no menos.
En la práctica, se apoya en tres cosas:
- un banner de cookies que explique el tratamiento del lado del servidor y por qué recibe datos cada proveedor,
- el consentimiento transmitido a cada partner junto con cada evento,
- un registro de las pruebas de consentimiento para poder demostrar quién aceptó qué.
Un reto conocido que conviene prever: en la primerísima interacción de un visitante todavía no se conoce su estado de consentimiento. Conseguir que la capa de consentimiento y el servidor se entiendan limpiamente en ese momento exige una configuración cuidadosa.
Un método de tracking de marketing más respetuoso con la privacidad
El lado del servidor es una forma más respetuosa de tratar los datos del usuario, porque todo pasa por un único punto de control antes de llegar a nadie más, y eso cambia aquello a lo que expones a tus visitantes.
La misma arquitectura que recupera tu señal te da también más control sobre los datos: los datos consentidos se tratan con más cuidado y los no consentidos no viajan a ningún sitio.
Otra implementación respetuosa con la privacidad para recuperar tracking que conviene mirar es el Modo de Consentimiento de Google. Les dice a las etiquetas de Google cómo comportarse según lo que cada usuario haya elegido en tu banner de cookies. Si acepta, el tracking funciona con normalidad. Si rechaza, la configuración avanzada envía pings limitados y sin cookies que cubren el hueco mediante modelado agregado en lugar de tracking individual.
- El tracking del lado del servidor captura todos los datos consentidos que puede, los que de otro modo se escaparían.
- El Modo de Consentimiento cubre el resto y llena el hueco de los usuarios que rechazan.
Juntos te dan una imagen del rendimiento más completa y más respetuosa con la privacidad, y ambos dependen de tu CMP para recoger un consentimiento válido de partida.
Configuración del tracking del lado del servidor, plataforma a plataforma
El tagging del lado del servidor funciona de forma algo distinta en cada plataforma. GA4, Meta, Google Ads, Shopify y WordPress tienen cada uno su mecanismo, pero todos siguen el mismo patrón: el servidor de tracking envía los eventos directamente a los servidores de la plataforma, sin navegador de por medio.
| Plataforma | Mecanismo del lado del servidor | Qué necesitas |
|---|---|---|
| GA4 | Contenedor de GTM del lado del servidor | Un contenedor sGTM (autoalojado o gestionado) con una etiqueta de GA4 |
| Meta (Facebook e Instagram) | Conversions API (CAPI) | Una conexión CAPI, normalmente a través de sGTM o de una integración de la plataforma |
| Google Ads | Conversiones mejoradas y tracking de conversiones del lado del servidor | Etiquetas de conversión enrutadas por el mismo contenedor de servidor |
| TikTok, LinkedIn, Microsoft Ads | TikTok Events API, LinkedIn Conversions API, Microsoft Ads UET | La API de servidor a servidor de cada plataforma, alimentada desde el servidor de tracking |
| Shopify, WooCommerce, WordPress | sGTM o integraciones de la plataforma | Una conexión entre tu tienda o tu sitio y el contenedor de servidor |
Algunas notas para ajustar expectativas:
- GA4 y Google Ads usan el mismo contenedor de servidor, así que, una vez configurado uno, el otro suele salir casi solo.
- Meta, TikTok, LinkedIn y Microsoft Ads tienen cada uno su forma de recibir eventos desde un servidor (en Meta se llama Conversions API), pero la idea siempre es la misma: los eventos llegan directamente a la plataforma, no a través del navegador.
- Shopify y WooCommerce se conectan mediante integraciones, así que las compras se registran desde tu tienda y no desde el navegador del comprador.
Cómo configurar el tracking del lado del servidor: lista de comprobación paso a paso
Así suele ser la implementación, sean cuales sean las herramientas que elijas:
- Monta la capa de servidor. Crea un servidor de tracking en la nube, normalmente un contenedor sGTM. Alójalo tú o recurre a una solución gestionada que lo ejecute por ti (mucho más fácil).
- Apunta un subdominio propio al servidor. Crea un subdominio en tu dominio (por ejemplo
analytics.tudominio.com) y dirígelo al servidor con un registro DNS. - Conecta tu CMP. Integra las señales de consentimiento en el servidor para que no se dispare nada antes de que el visitante haya elegido. Este paso es el que mantiene limpio todo el flujo.
- Decide qué pasa el filtro. Define qué filtrar, qué enriquecer y qué bloquear antes de reenviar cualquier dato a un proveedor.
- Conecta tus destinos. Envía los eventos a las plataformas que usas: GA4, Meta CAPI, Google Ads y el resto.
- Actualiza tu documentación de privacidad. Comprueba que tu política de privacidad y de cookies refleja los flujos de datos y los proveedores que reciben datos.
- Haz convivir los dos sistemas. Mantén el tracking del lado del cliente una o dos semanas y compara cifras. Si cuadran, puedes fiarte del nuevo flujo.
- Vigílalo y mantenlo. Revisa las señales de consentimiento, los flujos de datos y lo que recibe cada proveedor, y no dejes de mirar a medida que cambien las plataformas y las normas.
Piensa también en el equipo que vas a necesitar: marketing se ocupa de la configuración del tracking y de los objetivos, y una persona de desarrollo se encarga del subdominio y del enrutamiento. Con una solución gestionada, la carga técnica se reduce bastante.
Errores habituales del tracking del lado del servidor
El tracking del lado del servidor es potente, y por eso mismo es fácil configurarlo mal. Los fallos más habituales:
- Conversiones duplicadas. Tener a la vez un píxel en el navegador y una conexión del lado del servidor sin deduplicación cuenta dos veces la misma compra, y una cifra inflada engaña tanto como una incompleta.
- Datos personales sin hashear en los payloads del servidor. Más acceso a los datos es más responsabilidad: aplica un hash a los identificadores o elimínalos antes de que los eventos salgan del servidor.
- Un subdominio propio mal configurado. Si el enrutamiento DNS está mal, pierdes la conexión y puedes tardar semanas en darte cuenta.
- Ignorar el estado del consentimiento en los payloads del servidor. El servidor tiene que recibir y respetar la elección de cada visitante sobre el tracking, también en la delicada primera visita. Reenviar eventos no consentidos desde un servidor sigue siendo tracking sin consentimiento, y no cumple la normativa.
- Dar por hecho que el lado del servidor es invisible. El usuario no puede examinar el tratamiento del lado del servidor como examina las cookies, así que explícalo con claridad en tu banner de cookies y en tu documentación de privacidad. Cuanta menos visibilidad hay, más importa la transparencia.
Por dónde empezar
El tracking del lado del servidor te devuelve la señal que estás perdiendo y te da más control sobre lo que sale de tu sitio. Pero los datos que recupera solo sirven si el consentimiento viaja con ellos. Medir bien y respetar la privacidad del usuario no son objetivos enfrentados: en las mejores implementaciones son el mismo.
Tracking del lado del servidor con el cumplimiento incorporado
Configura también la parte de cumplimiento
FAQ: tracking del lado del servidor
¿El tracking del lado del servidor cumple el RGPD?
El tracking del lado del servidor ayuda a cumplir el RGPD, pero no lo consigue por sí solo. Cambia dónde se tratan los datos, no si el RGPD se aplica. Tratar datos personales exige una base jurídica se ejecute donde se ejecute, así que tus obligaciones siguen siendo las mismas. La diferencia real: el servidor te deja filtrar lo que sale, y los datos que ya no pueden vincularse a una persona (datos realmente anonimizados) no son datos personales según el RGPD.
¿El tracking del lado del servidor necesita consentimiento para cookies?
Sí, el tracking del lado del servidor necesita consentimiento para cookies. El requisito de consentimiento va unido al momento en que algo lee o escribe en el dispositivo del visitante, no al recorrido posterior del dato. Si un rastreador necesitaba consentimiento en el navegador, el flujo equivalente del lado del servidor también lo necesita. Tu CMP tiene que pasar la elección de cada visitante al servidor de tracking para que solo se reenvíen los datos consentidos.
¿Es legal el tagging del lado del servidor?
Sí, el tagging del lado del servidor es legal si tu infraestructura de consentimiento está bien montada. Lo que hace lícito el tracking no es dónde se ejecuta, sino si tienes una base jurídica para hacerlo. Llevar tus etiquetas a un servidor cambia la arquitectura, no tus obligaciones: si un rastreador necesitaba consentimiento en el navegador, también lo necesita en el servidor. Recomendamos usar una plataforma de gestión del consentimiento como iubenda, que pasa la elección de cada visitante al servidor de tracking para que solo se reenvíen los datos consentidos.
¿Es difícil configurar el tracking del lado del servidor?
El tracking del lado del servidor requiere un trabajo de configuración real, y cuánto trabajo depende del camino que elijas. Montarlo por tu cuenta es complejo y necesita tiempo de desarrollo: el contenedor, el subdominio, el servidor, el enrutamiento y el mantenimiento de todo ello con el tiempo. Con una solución gestionada, casi todo ese trabajo técnico desaparece: el proveedor se ocupa del servidor y tu parte ocurre en un dashboard, decidiendo qué recoger, qué filtrar y qué reenviar.
¿Necesito Google Tag Manager para el tagging del lado del servidor?
No, no necesitas Google Tag Manager para hacer tagging del lado del servidor, aunque sGTM es el camino más habitual. Vale cualquier sistema que reciba eventos en un servidor y los reenvíe a tus proveedores. sGTM es popular porque configurarlo no cuesta nada, funciona con GA4 y Google Ads desde el primer momento y es el que más documentación tiene detrás.
¿Cuánto cuesta el tagging del lado del servidor?
El coste del tagging del lado del servidor viene del alojamiento en la nube del contenedor de servidor, que se factura según el tráfico que le envías. Si contratas una suscripción gestionada en lugar de alojarlo tú, ese coste va incluido en la cuota. Lo mismo con el tiempo de configuración y mantenimiento, que es justo lo que más se subestima. Así que el coste se resume en alojamiento, configuración y mantenimiento, con el tiempo que tu equipo (sobre todo desarrollo) dedique a ello.
¿El tracking del lado del servidor elimina las cookies del todo?
No. El tracking del lado del servidor hace que tu tracking dependa menos de las cookies, pero no las elimina. El reenvío a los proveedores ocurre de servidor a servidor, así que las cookies de terceros que antes instalaban en el navegador los scripts de los proveedores dejan de ser necesarias en gran medida. Tu sitio sigue usando normalmente cookies propias para reconocer a los visitantes recurrentes, ahora escritas por el servidor y más duraderas. Los requisitos de consentimiento para esas cookies no cambian.
Tracking del lado del cliente o del lado del servidor: ¿cuál me conviene?
Elige el tracking del lado del servidor si inviertes en publicidad, necesitas datos de conversión precisos o estás construyendo una estrategia de datos propios. El del lado del cliente puede bastar si tus necesidades son básicas y no haces campañas de publicidad.