
Vos campagnes produisent plus de données que jamais. Mais arrivent-elles jusqu’à vos rapports ? Entre les bloqueurs de publicité, les restrictions des navigateurs et les trous dans le consentement, une part non négligeable des signaux disparaît avant d’atteindre vos outils d’analyse ou vos régies publicitaires. La réponse dont vous entendez parler partout — agences, commerciaux des régies, tutoriels GTM — porte un nom : le suivi côté serveur. Autant bien comprendre de quoi il s’agit.
D’après le rapport IAB State of Data 2024, 95 % des décideurs de la publicité et de la donnée s’attendent à ce que la perte de signal se poursuive, et plus de la moitié anticipent des difficultés croissantes pour attribuer la performance des campagnes, mesurer le ROI et suivre les conversions.
Dans la plupart des équipes, les dégâts passent inaperçus : vous réalisez 100 ventes, votre régie en comptabilise 60. Les budgets se déplacent alors en fonction de campagnes qui ne sous-performent qu’en apparence, et le cycle recommence.
Ce guide explique ce qu’est le suivi côté serveur, comment il fonctionne, ce qu’il vous apporte — et la seule chose qu’il ne change pas : vos obligations de consentement.
En bref
Le suivi côté serveur, parfois appelé tagging côté serveur, envoie d’abord les événements de votre site à un serveur de suivi, qui les nettoie avant de les transmettre à vos outils d’analyse et à vos régies publicitaires. Résultat : des données de conversion plus fiables, des pages plus rapides et un contrôle réel sur ce que reçoit chaque prestataire. Une chose ne change pas : le suivi reste soumis au consentement de l’utilisateur, et votre plateforme de gestion du consentement reste donc au cœur du dispositif.
Nous avons réuni tout le contenu de cet article — et bien plus — dans un livre blanc à garder sous la main.
Sans formulaire, sans email : juste le PDF.
Au sommaire :
- Qu’est-ce que le suivi côté serveur ?
- Tagging côté serveur et suivi côté serveur : quelle différence ?
- Suivi côté client et suivi côté serveur : quelle différence ?
- Comment fonctionne le suivi côté serveur ?
- Les avantages du suivi côté serveur
- Avez-vous besoin du suivi côté serveur ?
- Le suivi côté serveur remplace-t-il le consentement aux cookies ?
- La configuration du suivi côté serveur, plateforme par plateforme
- Mettre en place le suivi côté serveur : la marche à suivre
- Les erreurs les plus courantes du suivi côté serveur
- FAQ : le suivi côté serveur
- Par où commencer
Qu’est-ce que le suivi côté serveur ?
Le suivi côté serveur est une méthode de collecte des données de votre site dans laquelle le navigateur du visiteur envoie ses événements à un seul serveur de suivi : ce serveur traite les données, puis les transmet à vos outils d’analyse et à vos régies publicitaires. Au lieu de dizaines de scripts tiers qui expédient chacun leurs données depuis le navigateur vers leur propre prestataire, un flux unique passe d’abord par un serveur.
L’ordre a son importance : vous collectez d’abord, vous décidez ensuite de ce qui est utile, vous nettoyez, et vous n’envoyez que ce qui est nécessaire et consenti. Plus de contrôle pour vous, plus de respect de la vie privée pour vos visiteurs.
Rassurez-vous tout de suite : il ne s’agit pas de construire un serveur. La plupart des équipes marketing passent par une solution managée : le fournisseur exploite l’infrastructure, et tout votre travail se fait depuis un tableau de bord. Vous y gérez les données entrantes et décidez de ce qui part vers chaque prestataire.
Vous croiserez aussi le terme « tagging côté serveur ». Les deux notions sont proches, mais pas identiques : la section suivante détaille ce qui les distingue.
Besoin d’une remise à niveau sur le suivi en général ? Commencez par notre guide sur le fonctionnement du suivi sur un site web.
Tagging côté serveur et suivi côté serveur : quelle différence ?
Le tagging décrit le dispositif, le suivi décrit le résultat : voilà toute la différence. Le tagging côté serveur, c’est l’architecture : vos tags s’exécutent dans un conteneur hébergé sur un serveur, et non dans le navigateur du visiteur. Le suivi côté serveur, c’est ce que vous y gagnez : des données plus propres, moins de scripts sur la page et des événements qui atteignent vos plateformes là où un bloqueur les aurait arrêtés.
La plupart des marketeurs emploient les deux termes indifféremment, et cela ne pose généralement pas de problème : la nuance est avant tout architecturale.
Suivi côté client et suivi côté serveur : quelle différence ?
Que l’on parle de tagging ou de suivi, l’opposition côté client / côté serveur tient à deux choses : où les données sont collectées et qui les contrôle avant que les prestataires y accèdent. Pour une comparaison détaillée, voyez ce qui distingue le suivi côté client du suivi côté serveur.
| Suivi côté client | Suivi côté serveur | |
|---|---|---|
| Point de collecte | Le navigateur du visiteur | Un serveur de suivi |
| Maîtrise des données | Faible : les scripts peuvent collecter plus que nécessaire | Élevée : vous filtrez et nettoyez les données avant de les envoyer aux prestataires |
| Fiabilité | Dégradée par les bloqueurs de publicité et les limites des navigateurs | Résiste aux bloqueurs ; les événements consentis sont fiables |
| Performance des pages | Lourde : chaque script de prestataire se charge dans le navigateur | Légère : moins de scripts sur la page |
| Mise en place | Un simple extrait de code | Une infrastructure serveur ou une solution managée |
| Coût | Généralement gratuit | Frais d’hébergement ou abonnement à un outil dédié |
Comment fonctionne le suivi côté client
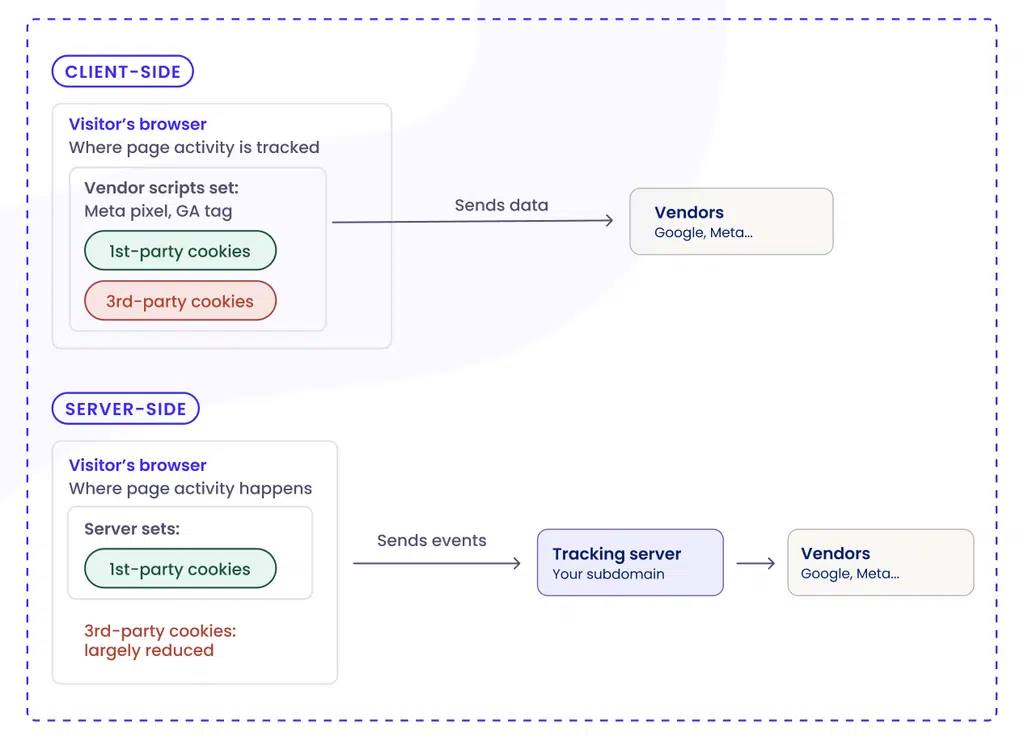
Le suivi côté client, c’est le montage classique : les tags, les pixels et les scripts se chargent directement dans le navigateur de vos visiteurs, et chacun envoie ses données à son propre tiers : Meta, Google Analytics, Google Ads et des dizaines d’autres.
Le modèle fonctionnait bien tant que les navigateurs jouaient le jeu et que les internautes bloquaient rarement quoi que ce soit. Ce n’est plus le cas : l’Intelligent Tracking Prevention (ITP) de Safari et l’Enhanced Tracking Protection (ETP) de Firefox peuvent limiter le suivi par défaut, et les bloqueurs de publicité sont partout.
Une idée reçue à corriger : Google a confirmé en 2025 que Chrome ne supprimerait finalement pas les cookies tiers. Le problème n’a pas disparu pour autant. Safari, Firefox et Edge les restreignent déjà, les bloqueurs de publicité continuent de se répandre et la réglementation sur la vie privée n’a rien perdu de sa portée. La perte de signal est bien réelle, quelle que soit la décision de tel ou tel navigateur.
Et comment fonctionne le suivi côté serveur
Avec le suivi côté serveur, le navigateur envoie un flux unique de données vers un serveur de suivi, généralement via un sous-domaine qui vous appartient. Ce sont ensuite les prestataires qui reçoivent leurs données de ce serveur, et non du navigateur du visiteur. Comme le navigateur ne dialogue qu’avec votre domaine, la requête ressemble à du trafic propriétaire (first-party) ordinaire : elle résiste bien mieux aux bloqueurs de publicité et aux limites des navigateurs. Les sections qui suivent détaillent ce mécanisme.
Comment fonctionne le suivi côté serveur ?
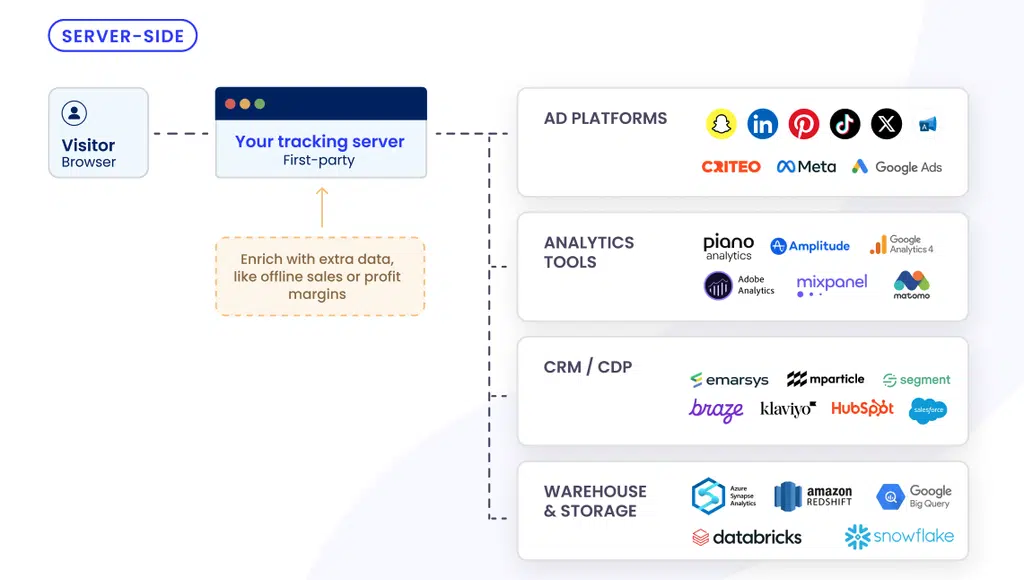
Le suivi côté serveur se déroule en quatre étapes :
- Le navigateur envoie un événement au serveur de suivi. Un visiteur clique, s’inscrit ou achète : l’événement rejoint le serveur par votre propre sous-domaine.
- Le serveur reçoit l’événement et le traite. Il s’agit en général d’un conteneur côté serveur : un environnement hébergé dans le cloud qui ingère les événements et applique vos règles.
- Le serveur filtre et enrichit les données. Vous écartez ce dont vous n’avez pas besoin, vous hachez ou supprimez les informations personnelles et vous ajoutez du contexte (la valeur d’une commande, par exemple) avant que quoi que ce soit ne sorte.
- Le serveur transmet des données propres à vos plateformes. GA4, Meta, Google Ads et les autres reçoivent leurs événements de serveur à serveur.
Le rôle du conteneur côté serveur
L’implémentation la plus répandue est le conteneur Google Tag Manager côté serveur, abrégé en GTM côté serveur ou sGTM. Ce type de montage fait tourner deux conteneurs : le conteneur web sur votre site et le conteneur serveur dans le cloud. Vous pouvez héberger ce dernier vous-même ou confier son exploitation à une solution managée ; la configuration, elle, reste la vôtre : votre paramétrage de suivi et vos règles.
Pourquoi le sous-domaine propriétaire est déterminant
Un bloqueur de publicité fait d’abord ce que son nom indique : empêcher l’affichage des publicités en ligne. Au fil du temps, la plupart d’entre eux ont étendu leur action aux scripts de suivi qui les accompagnent. En clair, ils empêchent les scripts tiers de collecter des données auxquelles les internautes n’ont jamais consenti.
Le côté serveur retire purement et simplement ces scripts de la page. Ce qui subsiste n’est pas du suivi passé entre les mailles du filet, mais une mesure en contexte propriétaire, consentie par l’internaute — ce que les bloqueurs n’ont jamais eu vocation à empêcher. Le navigateur ne dialogue qu’avec votre propre sous-domaine : la requête ressemble à du trafic propriétaire plutôt qu’à un traqueur identifié, et elle a moins de risques de déclencher la liste de blocage. Votre serveur transmet ensuite les données aux prestataires de serveur à serveur, là où les bloqueurs n’ont aucune visibilité.*
*Certains bloqueurs vont plus loin et bloquent directement un sous-domaine de suivi dès qu’ils comprennent qu’il sert à collecter des données. Le suivi côté serveur rend la perte de signal beaucoup moins probable, mais pas impossible.
Les avantages du suivi côté serveur
Les bénéfices du tagging côté serveur se répartissent en quatre domaines, et ils se renforcent les uns les autres.
Des données et une attribution plus fiables
C’est l’avantage que les équipes marketing remarquent en premier. Puisque les données de suivi transitent par un serveur hébergé sur votre propre domaine, votre dispositif résiste mieux aux bloqueurs de publicité et aux limites des navigateurs. L’Intelligent Tracking Prevention de Safari, par exemple, limite à 7 jours la durée des cookies écrits en JavaScript dans le navigateur. Les cookies déposés par un serveur dans la réponse HTTP peuvent vivre plus longtemps, mais Safari applique là aussi la limite de 7 jours lorsque le sous-domaine de suivi pointe vers un tiers. La façon dont le sous-domaine est configuré compte donc beaucoup.
Le suivi côté serveur fait remonter des conversions bien réelles qui n’étaient pas comptabilisées. Et cela touche directement l’indicateur qui compte le plus pour les annonceurs : le retour sur investissement publicitaire (ROAS).
Des données plus riches
Comme chaque événement passe d’abord par un serveur, vous pouvez relier ce serveur à vos propres systèmes — votre CRM ou votre base de commandes — et enrichir l’événement avant de le transmettre. C’est ce qu’on appelle l’enrichissement des données côté serveur, et les enchères basées sur la valeur et les règles de valeur de conversion de Google sont précisément conçues pour ce type de signal.
Associez à l’événement la marge d’un achat ou la valeur vie du client, et vous pouvez demander à l’algorithme de viser la rentabilité et les clients à forte valeur, plutôt que le seul volume de ventes.
Des pages plus rapides
Chaque script de suivi ajoute du poids que le navigateur doit télécharger et exécuter pendant que votre page tente de s’afficher. Résultat : un ralentissement, surtout sur mobile.
Le suivi côté serveur déporte l’essentiel de ce travail hors du navigateur. Moins de scripts sur la page, c’est un chargement plus rapide, de meilleurs Core Web Vitals et un meilleur référencement. La vitesse se traduit aussi en chiffre d’affaires : un site qui se charge en 1 seconde convertit jusqu’à 3 fois mieux qu’un site qui met 5 secondes.
Une conformité mieux maîtrisée
Faire transiter chaque événement par un serveur de suivi unique transforme la gouvernance des données en règle que vous pouvez réellement appliquer. Le serveur est le point de passage obligé de tous les événements : c’est donc là que vous fixez les règles :
- N’envoyez que le nécessaire. La minimisation des données est un principe fondamental du Règlement général sur la protection des données (RGPD). Le côté serveur la rend applicable : vous transmettez les champs dont un prestataire a besoin pour enregistrer une conversion, et vous laissez le reste de côté.
- Hachez ou supprimez les données personnelles. Pour chaque destination, vous décidez de ce qui sort : supprimer le champ, le hacher ou le laisser passer. Attention : le hachage relève de la pseudonymisation, pas de l’anonymisation. Un email haché reste une donnée personnelle et exige une base légale. Il limite malgré tout ce qu’un prestataire peut faire du champ au-delà de la correspondance dont il a besoin. Une précision pratique : chaque prestataire fixe un minimum d’informations pour qu’un événement soit accepté et rapproché ; ce que vous pouvez retirer dépend donc de la destination.
- Coupez les fuites de données à la source. Le passage de serveur à serveur empêche les scripts tiers d’aspirer dans le navigateur des informations qu’ils ne sont pas autorisés à collecter.
- Gardez une piste d’audit. Journalisez chaque flux de données : vous constituez ainsi les traces que les autorités attendent de plus en plus.
Les données propriétaires : le véritable actif que vous construisez
Tout cela converge vers un même virage stratégique : construire un actif de données qui vous appartient, au lieu de louer des signaux à des tiers en voie de disparition. Les données propriétaires sont les informations que vous collectez directement via vos propres canaux : elles sont plus fiables et plus respectueuses de la vie privée que les données tierces.
Le marché a déjà basculé : 71 % des marques, agences et éditeurs enrichissent leurs jeux de données propriétaires, et le BCG a constaté que les entreprises qui relient leurs sources de données propriétaires génèrent 1,5 fois plus de revenus incrémentaux à partir d’un même emplacement publicitaire, et améliorent deux fois plus leur efficacité budgétaire.
Un bémol : les données propriétaires ne valent que si vous pouvez les collecter licitement, les activer dans vos outils et les exploiter. Le consentement conditionne ces trois points ; si votre couche de consentement est mal conçue, chaque outil en aval hérite de la faille.
Comme le résume Andreea Mandeal, CMO d’iubenda, pour l’IAB Tech Lab, sans un cadre de consentement fiable, les données propriétaires « ne peuvent être exploitées en toute confiance par aucune équipe en aval ».
Avez-vous besoin du suivi côté serveur ?
Avant d’investir dans le suivi côté serveur, faites le point avec les questions ci-dessous. Demandez-vous :
- Investissez-vous en publicité, et avez-vous besoin de données de conversion fiables pour optimiser vos campagnes ?
- Comparez les conversions annoncées par votre régie avec vos ventes réelles : les chiffres concordent-ils ?
- Votre attribution sert-elle à de vraies décisions budgétaires, et pas seulement au reporting ?
- Construisez-vous une stratégie de données propriétaires que vous devez pouvoir activer de façon fiable ?
- Collectez-vous déjà vos données derrière une véritable couche de consentement ?
→ Si vous avez répondu oui à plusieurs d’entre elles, le suivi côté serveur vaut sans doute l’investissement dès maintenant. L’indicateur à surveiller de près reste l’écart entre les conversions déclarées et les conversions réelles : c’est là que se cache le budget gaspillé.
→ Le moment n’est peut-être pas venu si vos besoins d’analyse restent basiques et que vous n’investissez pas en publicité, ou si vous manquez de ressources techniques sans être prêt à passer par une solution managée qui prend en charge l’essentiel du travail complexe. Même chose si vous ne collectez pas encore vos données derrière une couche de consentement.
Le suivi côté serveur remplace-t-il le consentement aux cookies ?
Non, le suivi côté serveur ne remplace pas le consentement aux cookies. Il change l’endroit où vos données sont traitées, pas le fait que vous ayez besoin d’une autorisation pour les traiter. Si votre suivi exigeait un consentement lorsqu’il s’exécutait dans le navigateur, il l’exige toujours lorsqu’il s’exécute sur un serveur. C’est aussi le mythe le plus tenace autour du suivi côté serveur et du RGPD : il mérite qu’on s’y arrête.
Pourquoi le suivi côté serveur exige toujours une base légale au titre du RGPD
Le RGPD impose une base légale pour tout traitement de données personnelles (article 6) et, pour l’essentiel du suivi marketing, cette base est le consentement. La directive ePrivacy (la « loi cookies ») ajoute sa propre règle : stocker des identifiants sur l’appareil d’un utilisateur, ou y accéder, suppose en principe son consentement, quel que soit le trajet des données ensuite.
Déplacer le suivi vers un serveur change l’architecture, pas les obligations :
- Une plateforme de gestion du consentement (CMP) reste l’élément qui recueille le choix de chaque visiteur.
- Votre dispositif de gestion du consentement aux cookies doit transmettre ce choix au serveur de suivi, pour qu’il ne relaie que les données consenties.
- Votre politique de confidentialité et votre politique relative aux cookies doivent elles aussi refléter ce que vous collectez et qui le reçoit ; un générateur de politique de confidentialité garde cette documentation alignée sur votre dispositif réel.
Le traitement côté serveur étant moins visible pour les internautes que les scripts du navigateur, la transparence compte davantage, pas moins.
Concrètement, tout repose sur trois éléments :
- un bandeau de consentement qui explique le traitement côté serveur et la raison pour laquelle chaque prestataire reçoit des données,
- un consentement transmis à chaque partenaire avec chaque événement,
- un registre horodaté des consentements, pour pouvoir démontrer qui a accepté quoi.
Une difficulté connue, à anticiper : lors de la toute première interaction d’un visiteur, son choix n’est pas encore connu. Faire dialoguer proprement la couche de consentement et le serveur à cet instant précis demande un paramétrage soigné.
Le suivi côté serveur : une approche marketing plus respectueuse de la vie privée
Le côté serveur traite les données des utilisateurs avec plus d’égards : tout passe par un point de contrôle unique avant d’atteindre qui que ce soit, ce qui change ce à quoi vos visiteurs sont exposés.
L’architecture qui vous rend votre signal vous donne aussi plus de maîtrise sur les données : celles qui sont consenties sont traitées avec plus de soin, celles qui ne le sont pas ne circulent pas du tout.
Les marketeurs ont tout intérêt à se pencher sur une autre méthode de récupération du signal respectueuse de la vie privée : Google Consent Mode. Il indique aux tags Google comment se comporter selon le choix exprimé par chaque internaute sur votre bandeau de consentement. En cas d’acceptation, le suivi fonctionne normalement. En cas de refus, la configuration avancée envoie des pings limités et sans cookies, qui comblent le manque par modélisation agrégée plutôt que par un suivi individuel.
- Le suivi côté serveur récupère le maximum de vos données consenties, celles qui vous échappaient.
- Google Consent Mode prend le relais pour le reste, en comblant le manque laissé par les refus.
Ensemble, ils vous donnent une vision plus complète de vos performances, dans le respect de la vie privée, et l’un comme l’autre dépendent de votre CMP pour recueillir un consentement valable dès le départ.
La configuration du suivi côté serveur, plateforme par plateforme
Le tagging côté serveur fonctionne un peu différemment selon la plateforme. GA4, Meta, Google Ads, Shopify et WordPress ont chacun leur propre mécanisme côté serveur, mais tous suivent le même principe : le serveur de suivi envoie les événements directement aux serveurs de la plateforme, sans passer par le navigateur.
| Plateforme | Mécanisme côté serveur | Ce qu’il vous faut |
|---|---|---|
| GA4 | Conteneur GTM côté serveur | Un conteneur sGTM (auto-hébergé ou managé) avec un tag GA4 |
| Meta (Facebook et Instagram) | Conversions API (CAPI) | Une connexion CAPI, en général via sGTM ou une intégration native |
| Google Ads | Conversions optimisées et suivi des conversions côté serveur | Des tags de conversion acheminés par le même conteneur serveur |
| TikTok, LinkedIn, Microsoft Ads | TikTok Events API, LinkedIn Conversions API, Microsoft Ads UET | L’API serveur à serveur de la plateforme, alimentée par le serveur de suivi |
| Shopify, WooCommerce, WordPress | sGTM ou intégrations natives | Une connexion entre votre boutique ou votre site et le conteneur serveur |
Quelques précisions pour éviter les mauvaises surprises :
- GA4 et Google Ads partagent le même conteneur serveur : une fois l’un configuré, l’autre suit généralement sans grand effort supplémentaire.
- Meta, TikTok, LinkedIn et Microsoft Ads ont chacun leur façon de recevoir des événements depuis un serveur (chez Meta, c’est la Conversions API), mais le principe ne change pas : les événements arrivent directement sur la plateforme, sans passer par le navigateur.
- Shopify et WooCommerce se connectent via des intégrations : les achats sont enregistrés depuis votre boutique, et non depuis le navigateur de l’acheteur.
Mettre en place le suivi côté serveur : la marche à suivre
La mise en place ressemble généralement à ceci, quels que soient les outils retenus :
- Mettez en place la couche serveur. Créez un serveur de suivi dans le cloud, le plus souvent un conteneur sGTM. Hébergez-le vous-même ou confiez-le à une solution managée, nettement plus simple.
- Faites pointer un sous-domaine personnalisé vers ce serveur. Créez un sous-domaine sur votre propre domaine (par exemple
analytics.votredomaine.com) et dirigez-le vers le serveur avec un enregistrement DNS. - Connectez votre CMP. Reliez les signaux de consentement au serveur pour que rien ne se déclenche avant que le visiteur ait fait son choix. C’est cette étape qui garantit l’intégrité de toute la chaîne.
- Décidez de ce qui passe. Définissez ce qu’il faut filtrer, enrichir ou bloquer avant toute transmission à un prestataire.
- Connectez vos destinations. Transmettez les événements aux plateformes que vous utilisez : GA4, Meta CAPI, Google Ads et les autres.
- Mettez à jour votre documentation. Vérifiez que votre politique de confidentialité et votre politique relative aux cookies reflètent bien les flux de données et les prestataires destinataires.
- Faites tourner les deux dispositifs en parallèle. Gardez le suivi côté client pendant une à deux semaines et comparez les chiffres. S’ils concordent, vous pouvez faire confiance à la nouvelle chaîne.
- Surveillez et entretenez. Contrôlez les signaux de consentement, les flux de données et ce que reçoit chaque prestataire, et restez attentif aux évolutions des plateformes et de la réglementation.
Pensez à l’équipe à réunir : le marketing pilote la configuration du suivi et les objectifs, un développeur s’occupe du sous-domaine et du routage. Avec une solution managée, la charge technique diminue nettement.
Les erreurs les plus courantes du suivi côté serveur
Les montages côté serveur offrent beaucoup de latitude, ce qui les rend aussi faciles à mal configurer. Les défaillances les plus fréquentes :
- Les conversions comptées deux fois. Faire tourner un pixel navigateur et une connexion côté serveur sans déduplication revient à compter deux fois le même achat, et des chiffres gonflés induisent autant en erreur que des chiffres manquants.
- Des données personnelles non hachées dans les charges utiles serveur. Plus d’accès aux données, c’est plus de responsabilité : hachez ou supprimez les identifiants avant que les événements ne quittent le serveur.
- Un sous-domaine propriétaire mal configuré. Si le routage DNS est erroné, la connexion est rompue, et vous pouvez ne vous en apercevoir que des semaines plus tard.
- L’état du consentement ignoré dans les charges utiles serveur. Le serveur doit recevoir et respecter le choix de chaque visiteur, y compris lors de la délicate première visite. Transmettre depuis un serveur des événements non consentis reste du suivi non consenti, et donc non conforme.
- Considérer le côté serveur comme invisible. Les internautes ne peuvent pas observer un traitement côté serveur comme ils inspectent des cookies : expliquez-le ouvertement dans votre bandeau de consentement et votre documentation. Moins il y a de visibilité, plus la transparence compte.
Par où commencer
Le suivi côté serveur vous rend le signal que vous perdez et vous donne plus de maîtrise sur ce qui sort de votre site. Mais les données récupérées ne sont exploitables que si le consentement les accompagne. Mesure fiable et respect de la vie privée ne s’opposent pas : les meilleurs dispositifs n’en font qu’un seul et même objectif.
Le suivi côté serveur, avec la conformité intégrée
Gérer aussi la conformité, en toute simplicité
FAQ : le suivi côté serveur
Le suivi côté serveur est-il conforme au RGPD ?
Le suivi côté serveur facilite votre conformité au RGPD, mais il ne la produit pas à lui seul. Il change le lieu de traitement des données, pas l’applicabilité du RGPD. Traiter des données personnelles suppose une base légale, où que le traitement ait lieu : vos obligations restent les mêmes. La vraie différence : le serveur vous permet de filtrer ce qui sort, et des données qui ne peuvent plus être rattachées à une personne (véritablement anonymisées) ne sont plus des données personnelles au sens du RGPD.
Le suivi côté serveur nécessite-t-il un consentement aux cookies ?
Oui, le suivi côté serveur suppose un consentement aux cookies. L’obligation se rattache au moment où un élément est lu sur l’appareil d’un visiteur ou y est inscrit, et non au trajet que prennent ensuite les données. Si un traqueur exigeait un consentement dans le navigateur, son équivalent côté serveur l’exige aussi. Votre CMP doit transmettre le choix de chaque visiteur au serveur de suivi : seules les données consenties sont alors relayées.
Le tagging côté serveur est-il légal ?
Oui, le tagging côté serveur est légal dès lors que votre dispositif de recueil du consentement est bien conçu. Ce qui rend un suivi licite, ce n’est pas l’endroit où il s’exécute, mais l’existence d’une base légale. Déplacer vos tags vers un serveur change l’architecture, pas vos obligations : si un traqueur avait besoin d’un consentement dans le navigateur, il en a besoin côté serveur aussi. Nous recommandons vivement une plateforme de gestion du consentement comme iubenda, qui transmet le choix de chaque visiteur au serveur de suivi : seules les données consenties sont alors relayées.
Le suivi côté serveur est-il difficile à mettre en place ?
Le suivi côté serveur demande un vrai travail de mise en place, plus ou moins lourd selon la voie choisie. Le construire soi-même est complexe et mobilise du temps de développement : conteneur, sous-domaine, serveur, routage, puis maintenance dans la durée. Avec une solution managée, l’essentiel de ce travail technique disparaît : le fournisseur exploite le serveur, et votre part se joue dans un tableau de bord, où vous décidez de ce que vous collectez, filtrez et transmettez.
Faut-il Google Tag Manager pour faire du tagging côté serveur ?
Non. Le GTM côté serveur reste la voie la plus répandue, mais Google Tag Manager n’a rien d’obligatoire : tout dispositif capable de recevoir des événements sur un serveur et de les transmettre à vos prestataires fait l’affaire. Si sGTM domine, c’est parce que sa configuration est gratuite, qu’il fonctionne nativement avec GA4 et Google Ads et qu’il bénéficie de la documentation la plus fournie.
Combien coûte le tagging côté serveur ?
Le coût du tagging côté serveur vient de l’hébergement cloud du conteneur serveur, facturé selon le volume de trafic qui y transite. Si vous passez par un abonnement managé plutôt que par un hébergement maison, ce coût est intégré à l’abonnement. Il faut y ajouter le temps de mise en place et de maintenance, celui que les équipes sous-estiment le plus. Le budget se résume donc à trois postes : l’hébergement, la mise en place et l’entretien, temps de vos développeurs compris.
Le suivi côté serveur supprime-t-il totalement les cookies ?
Non. Le suivi côté serveur réduit la dépendance de votre dispositif aux cookies, sans les faire disparaître. La transmission aux prestataires se fait de serveur à serveur : les cookies tiers que déposaient leurs scripts dans le navigateur deviennent en grande partie inutiles. Votre site continue en général d’utiliser des cookies propriétaires pour reconnaître les visiteurs qui reviennent, déposés cette fois par le serveur et donc plus durables. Les obligations de consentement, elles, ne changent pas.
Suivi côté client ou côté serveur : lequel choisir ?
Choisissez le suivi côté serveur si vous investissez en publicité, si vous avez besoin de données de conversion fiables ou si vous construisez une stratégie de données propriétaires. Le côté client peut suffire si vos besoins restent simples et que vous ne menez pas de campagnes publicitaires.