
Votre plateforme publicitaire annonce moins de conversions que votre boutique n’en a réellement enregistrées. Un air de déjà-vu ? L’écart tient souvent à un seul choix : suivi côté client ou suivi côté serveur.
Le suivi côté client envoie les données du navigateur du visiteur directement à chaque fournisseur, Meta ou Google par exemple. Le suivi côté serveur les fait d’abord transiter par un serveur de suivi, qui les transmet ensuite. Ce simple changement détermine la quantité de données que vous conservez, la vitesse de chargement de vos pages et votre marge de manœuvre sur ce que reçoit chaque fournisseur.
En bref
Le suivi côté client envoie les données du navigateur du visiteur directement à chaque fournisseur. Le suivi côté serveur les fait d’abord passer par un serveur de suivi : vous perdez moins de données consenties et vous maîtrisez ce que reçoit chaque fournisseur, moyennant un coût récurrent. Dans les deux cas, le consentement de l’utilisateur reste obligatoire.
Au sommaire :
- Qu’est-ce que le suivi côté client ?
- Qu’est-ce que le suivi côté serveur ?
- Suivi côté client ou côté serveur : les principales différences
- Pourquoi le suivi côté client perd des données
- Le suivi côté serveur exige-t-il toujours le consentement ?
- Faites le point : lequel choisir ?
- FAQ : suivi côté client ou côté serveur
Qu’est-ce que le suivi côté client ?
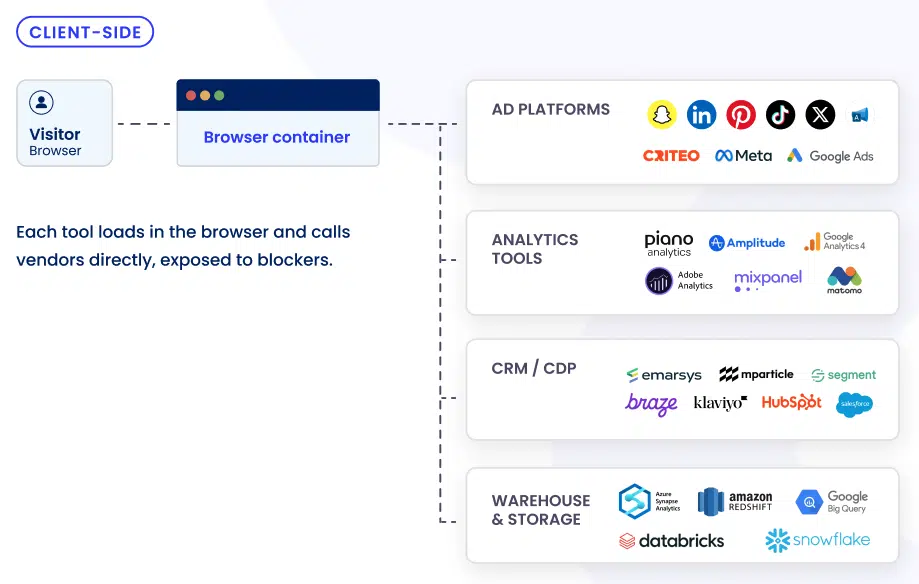
Le suivi côté client est la méthode standard pour mesurer ce que font les visiteurs d’un site : les pages qu’ils consultent, leur parcours sur votre site, l’annonce qui les a amenés, et s’ils achètent ou s’inscrivent. Les balises, les pixels et les scripts se chargent dans le navigateur du visiteur, et chacun envoie ses données directement à son fournisseur : Meta, Google Analytics ou Google Ads.
Imaginons qu’un internaute arrive sur votre page produit depuis une publicité Instagram. Le Meta Pixel se déclenche dans son navigateur et signale la visite à Meta. De son côté, Google Analytics fait la même chose pour Google.
Son succès s’explique : vous collez un bout de code et tout fonctionne, le plus souvent gratuitement. La contrepartie : chaque script s’exécute dans le navigateur du visiteur, où les restrictions des navigateurs et les bloqueurs de publicités peuvent l’arrêter, et chacun alourdit la page.
Qu’est-ce que le suivi côté serveur ?
Le suivi côté serveur déplace la collecte des données marketing du navigateur vers un serveur. Au lieu d’appeler chaque fournisseur, le navigateur envoie un flux unique d’événements vers un serveur de suivi hébergé sur un sous-domaine de votre site. Ce serveur vous donne la main sur les données (filtrage, enrichissement) avant de les transmettre à des plateformes comme Google et Meta.
Cela ne veut pas dire monter un serveur vous-même. La plupart des équipes marketing passent par une solution managée : le prestataire gère l’infrastructure, vous définissez les règles depuis un tableau de bord. Pour le détail complet, voici comment fonctionne le suivi côté serveur.
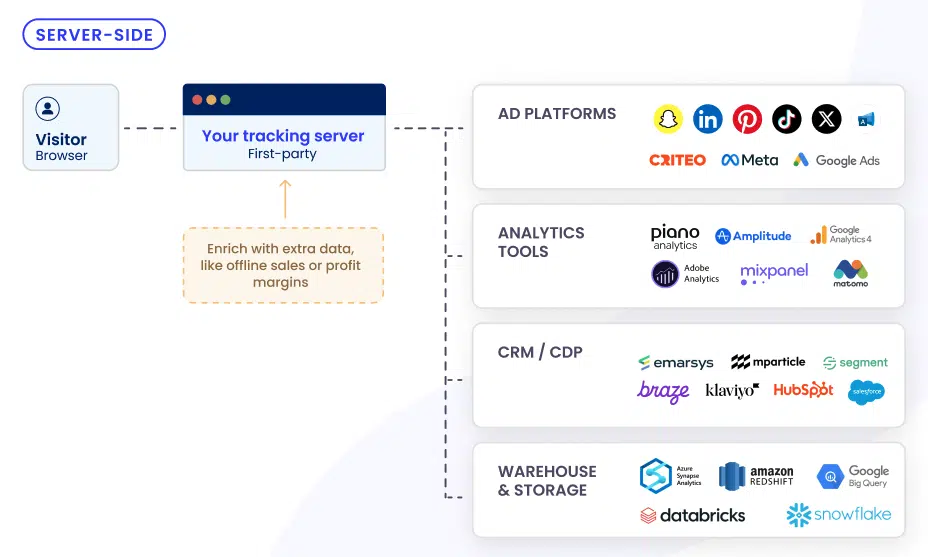
Comme le serveur de suivi est hébergé sur un sous-domaine de votre site, la collecte se fait en contexte propriétaire (first-party). Le navigateur dialogue avec votre site, et non avec le domaine d’un fournisseur, et le serveur peut déposer lui-même des cookies propriétaires. C’est ce qui fait du suivi côté serveur le socle d’une stratégie de données propriétaires.
Suivi côté client ou côté serveur : les principales différences
Voici une comparaison point par point du suivi côté client et du suivi côté serveur.
| Suivi côté client | Suivi côté serveur | |
|---|---|---|
| Lieu de collecte des données | Dans le navigateur du visiteur | Sur un serveur de suivi, qui reçoit un flux unique d’événements depuis le navigateur |
| Qui décide de ce que reçoivent les fournisseurs | Le script de chaque fournisseur, qui peut lire toute la page | Vous, en filtrant et en nettoyant les données (hachage) avant leur transmission |
| Exposition aux bloqueurs de publicités et aux restrictions des navigateurs | Élevée : les scripts appellent directement les domaines des fournisseurs | Plus faible : le navigateur ne dialogue qu’avec votre propre sous-domaine |
| Cookies | Cookies tiers des fournisseurs et cookies propriétaires déposés dans le navigateur | Essentiellement des cookies propriétaires, déposés par le serveur et de plus longue durée |
| Vitesse des pages | Chaque script alourdit la page | Moins de scripts dans le navigateur, donc des pages plus rapides |
| Mise en place | Un bout de code | Un serveur de suivi et un sous-domaine personnalisé, ou une solution managée dédiée (outil de suivi côté serveur) |
| Coût | Gratuit le plus souvent | Frais d’hébergement ou d’abonnement récurrents |
| Consentement de l’utilisateur | Obligatoire | Obligatoire |
Pourquoi le suivi côté client perd des données
Avec le suivi côté client, chaque balise appelle son fournisseur directement depuis le navigateur : toutes ces requêtes se font au grand jour. Les navigateurs limitent désormais le suivi par défaut, via Intelligent Tracking Prevention (ITP) de Safari et Enhanced Tracking Protection (ETP) de Firefox. Les bloqueurs de publicités, eux, se sont largement répandus. Conçus au départ pour écarter les publicités, la plupart filtrent aussi les scripts de suivi qui les accompagnent.
Le suivi côté serveur change l’itinéraire. Le navigateur ne dialogue qu’avec un serveur de suivi hébergé sur votre propre sous-domaine : la requête ressemble à du trafic propriétaire plutôt qu’à un traqueur connu. Le serveur transmet ensuite les données à Google ou Meta de serveur à serveur, hors de portée des bloqueurs de publicités. Rien de tout cela ne passe outre le choix des internautes : les bloqueurs existent pour empêcher une collecte que personne n’a acceptée, tandis que le côté serveur préserve la mesure à laquelle les utilisateurs ont bien consenti.
Le suivi côté serveur n’est pas infaillible, mais il permet de récupérer une bonne part des données. Certains bloqueurs de publicités filtrent un sous-domaine de suivi dès qu’ils en identifient la fonction : le côté serveur rend donc la perte de données moins probable, pas impossible. Et ces données perdues coûtent cher : vos plateformes publicitaires optimisent sur une vision partielle, et votre budget suit.
Le suivi côté serveur exige-t-il toujours le consentement de l’utilisateur ?
Oui, le suivi côté serveur exige toujours le consentement. Déplacer le suivi vers un serveur change le lieu de traitement des données, pas la nécessité d’obtenir une autorisation pour les traiter. La directive européenne ePrivacy impose de recueillir le consentement avant toute lecture ou écriture sur l’appareil d’un visiteur, et le Règlement général sur la protection des données (RGPD) encadre les données personnelles que vous traitez ensuite. Pour les détails juridiques, découvrez si le suivi côté serveur est conforme au RGPD.
Dans une configuration bien conçue, c’est le consentement qui commande. Votre plateforme de gestion du consentement (CMP) détermine :
- les cookies et identifiants que votre site peut déposer,
- le moment où le suivi peut commencer,
- les fournisseurs qui reçoivent les données.
Reliez votre CMP au serveur de suivi : celui-ci ne transmettra que les données que l’utilisateur a accepté de partager. Ce choix, les visiteurs l’expriment dans votre bandeau de consentement.
Faites le point : lequel choisir ?
Suivi côté client ou suivi côté serveur ? Tout dépend de la place qu’occupent les données de conversion dans vos arbitrages budgétaires et du fait que vous recueilliez déjà le consentement ou non. Passez en revue les questions suivantes.
- Commencez par là : recueillez-vous le consentement via une CMP ? Si ce n’est pas le cas, mettez-la en place d’abord. Un serveur de suivi ne transmet que ce que les utilisateurs ont accepté de partager : sans couche de consentement, il n’y a rien de fiable à envoyer. iubenda réunit la gestion du consentement et le suivi côté serveur dans un même système, pour une installation simple.
Le suivi côté serveur vaut probablement l’investissement si vous répondez oui à plusieurs de ces questions :
- Investissez-vous en publicité et avez-vous besoin de données de conversion fiables pour optimiser vos campagnes ?
- Vos plateformes publicitaires annoncent-elles moins de conversions que vous n’avez réellement vendu ? C’est le signal le plus net : c’est dans cet écart que se cache le budget gaspillé.
- L’attribution pèse-t-elle sur vos décisions budgétaires, et pas seulement sur vos rapports ?
- Constituez-vous des données propriétaires que vous devez exploiter de façon fiable dans l’ensemble de vos outils ?
- Disposez-vous des compétences techniques pour exploiter un serveur de suivi, ou préférez-vous confier cela à une solution managée ?
Le suivi côté client peut suffire pour l’instant si vous répondez oui à celles-ci :
- Des statistiques de base (trafic, pages les plus vues, sources) vous suffisent-elles ?
- Investissez-vous peu ou pas du tout en publicité payante ?
- Le coût et l’entretien d’un serveur de suivi pèseraient-ils plus lourd que les données qu’il permet de récupérer ?
- Le nombre de conversions remontées est-il déjà proche de vos ventes réelles ?
Rien ne vous oblige à tout basculer d’un coup. Meta recommande par exemple d’utiliser sa Conversions API en parallèle du Meta Pixel : les deux dispositifs se complètent. Google Tag Manager côté serveur est un autre point de départ courant.
Avant de basculer, faites tourner les deux en parallèle pendant une ou deux semaines et comparez chacun à vos ventes réelles.
Un suivi côté serveur avec la conformité intégrée
FAQ : suivi côté client ou côté serveur
Le suivi côté serveur utilise-t-il des cookies ?
Oui, le suivi côté serveur utilise toujours des cookies, mais moins de cookies tiers. Les données parviennent aux fournisseurs de serveur à serveur : les cookies tiers que leurs scripts déposaient dans le navigateur deviennent largement inutiles. Votre site continue d’utiliser des cookies propriétaires pour reconnaître les visiteurs qui reviennent, et un serveur peut les déposer lui-même. Puisque des cookies restent en jeu, les obligations de consentement ne changent pas.
Les bloqueurs de publicités peuvent-ils bloquer le suivi côté serveur ?
Les bloqueurs de publicités peuvent intercepter le suivi côté serveur, mais c’est beaucoup moins probable. Le navigateur envoie les données vers un sous-domaine de votre propre site, et non vers les domaines de fournisseurs que les bloqueurs surveillent : les requêtes ressemblent à du trafic propriétaire. Certains bloqueurs finissent effectivement par filtrer un sous-domaine de suivi dès qu’ils en identifient la fonction : le côté serveur réduit la perte de données, il ne la supprime pas.
À quoi ressemble le suivi côté serveur en pratique ?
L’exemple le plus courant de suivi côté serveur est la Meta Conversions API. Au lieu de s’appuyer uniquement sur le Meta Pixel dans le navigateur, un serveur envoie les événements de conversion — un achat, par exemple — directement à Meta. Meta recommande de l’utiliser en parallèle du Pixel, avec une déduplication des deux flux pour que chaque achat ne soit compté qu’une fois.
Le balisage côté serveur et le suivi côté serveur, est-ce la même chose ?
Le balisage côté serveur et le suivi côté serveur recouvrent presque la même réalité, et la plupart des gens emploient les deux termes indifféremment. À la lettre, le balisage désigne le dispositif : les conteneurs et les déclencheurs qui traitent les événements. Le suivi désigne l’objectif : mesurer les actions des utilisateurs et les conversions. Choisir entre balisage côté serveur et balisage côté client revient donc exactement à choisir votre manière de mesurer.