
La tua piattaforma pubblicitaria segnala meno conversioni di quelle che il tuo negozio online ha registrato davvero. Ti è mai capitato? Spesso dipende tutto da una scelta: client-side o server-side tracking.
Il client-side tracking invia i dati dal browser del visitatore direttamente a ogni fornitore, come Meta e Google. Il server-side tracking li manda prima a un tracking server, che poi li inoltra. Questo cambio di rotta incide sulla quantità di dati che conservi, sulla velocità delle tue pagine e sul controllo che hai su ciò che riceve ogni fornitore.
In breve
Il client-side tracking invia i dati dal browser del visitatore direttamente a ogni fornitore. Il server-side tracking li fa passare prima da un tracking server: perdi meno dati raccolti con il consenso e decidi cosa riceve ogni fornitore, a fronte di un costo ricorrente. In entrambi i casi serve il consenso dell’utente.
In questa guida:
- Che cos’è il client-side tracking?
- Che cos’è il server-side tracking?
- Client-side vs server-side tracking: le differenze principali
- Perché il client-side tracking perde dati
- Il server-side tracking richiede comunque il consenso?
- Checklist: quale scegliere?
- FAQ: client-side vs server-side tracking
Che cos’è il client-side tracking?
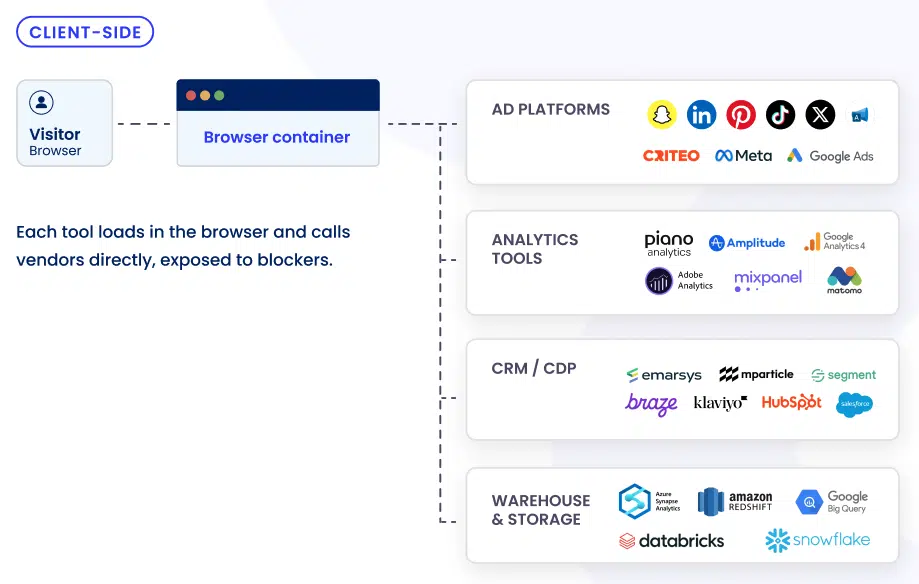
Il client-side tracking è il modo standard con cui i siti misurano il comportamento dei visitatori: quali pagine guardano, come si muovono nel tuo sito, quale annuncio li ha portati lì e se acquistano o si registrano. Tag, pixel e script si caricano nel browser del visitatore e ognuno invia i dati direttamente al proprio fornitore, come Meta, Google Analytics o Google Ads.
Immagina che qualcuno arrivi sulla tua pagina prodotto da un annuncio su Instagram: il Meta Pixel si attiva nel suo browser e segnala la visita a Meta, mentre Google Analytics fa lo stesso per Google, separatamente.
È diffuso per buoni motivi: incolli uno snippet e funziona, di solito gratis. Il rovescio della medaglia è che ogni script gira nel browser del visitatore, dove i limiti dei browser e gli ad blocker possono bloccarlo, e appesantisce la pagina.
Che cos’è il server-side tracking?
Il server-side tracking sposta la raccolta dei dati di marketing dal browser a un server. Invece di contattare ogni fornitore, il browser invia un unico flusso di eventi a un tracking server ospitato su un sottodominio del tuo sito. Lì hai più controllo sui dati, che puoi filtrare e arricchire prima che il server li inoltri a piattaforme come Google e Meta.
Non significa che devi costruirti un server. La maggior parte dei team marketing sceglie una soluzione gestita: l’infrastruttura la gestisce il fornitore, tu imposti le regole dalla dashboard. Per il quadro completo, ecco come funziona il server-side tracking.
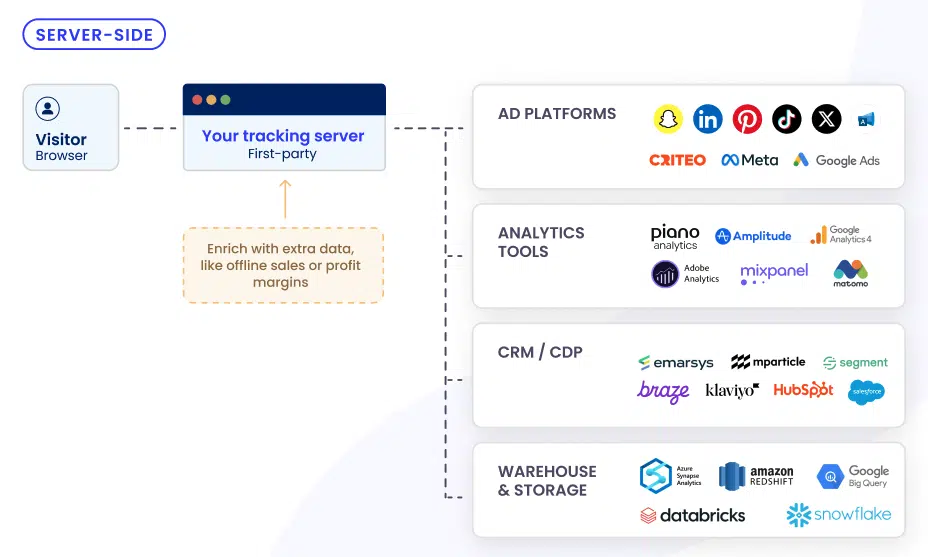
Visto che il tracking server si trova su un sottodominio del tuo sito, la raccolta dei dati avviene in un contesto first-party: il browser dialoga con il tuo sito invece che con il dominio di un fornitore, e il server può impostare direttamente i cookie di prima parte. È proprio questo a rendere il server-side tracking la base di una strategia di first-party data.
Client-side vs server-side tracking: le differenze principali
Ecco un confronto diretto tra client-side tracking e server-side tracking.
| Client-side tracking | Server-side tracking | |
|---|---|---|
| Dove si raccolgono i dati | Nel browser del visitatore | Su un tracking server, che riceve un unico flusso di eventi dal browser |
| Chi decide cosa ricevono i fornitori | Lo script di ogni fornitore, che può leggere l’intera pagina | Tu, filtrando e ripulendo i dati (hashing) prima che siano inoltrati |
| Esposizione agli ad blocker e ai limiti dei browser | Alta: gli script contattano direttamente i domini dei fornitori | Più bassa: il browser dialoga solo con il tuo sottodominio |
| Cookie | Cookie di terze parti dei fornitori, più cookie di prima parte impostati nel browser | Soprattutto cookie di prima parte, impostati dal server e più duraturi |
| Velocità delle pagine | Ogni script appesantisce la pagina | Meno script nel browser, quindi pagine più veloci |
| Configurazione | Uno snippet di codice | Un tracking server e un sottodominio personalizzato, oppure una soluzione gestita dedicata (uno strumento di server-side tracking) |
| Costi | Di solito gratuito | Costi ricorrenti di hosting o abbonamento |
| Consenso dell’utente | Obbligatorio | Obbligatorio |
Perché il client-side tracking perde dati
Con il client-side tracking ogni tag contatta il proprio fornitore direttamente dal browser, quindi ogni richiesta è allo scoperto. Oggi i browser limitano il tracking per impostazione predefinita, con Intelligent Tracking Prevention (ITP) di Safari e Enhanced Tracking Protection (ETP) di Firefox. Anche gli ad blocker si sono diffusi: nati per bloccare la pubblicità, oggi quasi tutti bloccano anche gli script di tracking che la accompagnano.
Il server-side tracking cambia percorso: il browser dialoga solo con un tracking server sul tuo sottodominio, quindi la richiesta sembra traffico first-party e non un tracker noto. Da lì il server inoltra i dati a Google o Meta da server a server, dove gli ad blocker non hanno visibilità. Questo non scavalca la scelta di nessuno: gli ad blocker fermano la raccolta di dati a cui le persone non hanno mai acconsentito, mentre il server-side tracking preserva la misurazione a cui hanno detto sì.
Il server-side tracking non è infallibile, ma può aiutarti a recuperare buona parte dei dati. Alcuni ad blocker bloccano un sottodominio di tracking quando ne capiscono la funzione: la perdita di dati diventa meno probabile, non impossibile. E i dati persi costano: le piattaforme pubblicitarie ottimizzano su un quadro incompleto e il tuo budget segue.
Il server-side tracking richiede comunque il consenso dell’utente?
Sì, il server-side tracking richiede comunque il consenso. Spostare il tracking su un server cambia il luogo in cui i dati sono trattati, non la necessità di un permesso per trattarli. La Direttiva ePrivacy dell’UE impone il consenso prima che qualcosa legga o scriva sul dispositivo del visitatore, e il Regolamento generale sulla protezione dei dati (GDPR) disciplina i dati personali che gestisci dopo. Per i dettagli legali, leggi se il server-side tracking è conforme al GDPR.
In una configurazione fatta bene il consenso fa da filtro: la tua piattaforma di gestione del consenso (CMP) stabilisce:
- quali cookie e identificatori può impostare il tuo sito,
- quando può iniziare il tracking,
- quali fornitori ricevono i dati.
Collega la CMP al tracking server e il server inoltrerà solo i dati che l’utente ha accettato di condividere. I visitatori fanno questa scelta nel tuo cookie banner.
Checklist: quale scegliere?
Meglio il client-side o il server-side tracking? Dipende da due cose: quanto il tuo budget si basa sui dati di conversione e se hai già una gestione del consenso attiva. Rispondi alle domande qui sotto.
- Parti da qui: raccogli il consenso con una CMP? Se no, comincia da lì. Un tracking server inoltra solo ciò che gli utenti hanno accettato di condividere, quindi senza un livello di consenso non c’è nulla di affidabile da inviare. iubenda ha integrato in un unico sistema la gestione del consenso e il server-side tracking, per una configurazione semplice.
Il server-side tracking probabilmente ti conviene se rispondi sì a più di una di queste domande:
- Investi in pubblicità e ti servono dati di conversione accurati per ottimizzare le campagne?
- Le tue piattaforme pubblicitarie segnalano meno conversioni di quelle che hai davvero venduto? È il segnale più chiaro: in quello scarto si nasconde il budget sprecato.
- L’attribuzione guida decisioni di budget reali, e non solo i report?
- Stai costruendo first-party data che devi poter usare in modo affidabile su tutti i tuoi strumenti?
- Hai il supporto tecnico per gestire un tracking server, o sei disposto a usare una soluzione gestita che se ne occupi al posto tuo?
Il client-side tracking può bastare per ora se rispondi sì a queste:
- Ti bastano le statistiche di base (traffico, pagine più viste, sorgenti)?
- Fai poca o nessuna pubblicità a pagamento?
- Il costo e la manutenzione di un tracking server peserebbero più dei dati che ti farebbe recuperare?
- Le conversioni registrate sono già vicine alle vendite reali?
Non devi cambiare tutto in una volta. Meta, per esempio, consiglia di affiancare la Conversions API al Meta Pixel, così le due configurazioni lavorano insieme. Un altro punto di partenza comune è Google Tag Manager server-side.
Prima di cambiare, falli girare in parallelo per una o due settimane e confronta entrambi con le vendite reali.
Server-side tracking con la conformità integrata
FAQ: client-side vs server-side tracking
Il server-side tracking usa i cookie?
Sì, il server-side tracking usa ancora i cookie, solo meno cookie di terze parti. I dati arrivano ai fornitori da server a server, quindi i cookie di terze parti che i loro script rilasciavano nel browser diventano quasi superflui. Il tuo sito usa ancora i cookie di prima parte per riconoscere chi torna, e può impostarli il server stesso. Visto che i cookie restano in gioco, gli obblighi di consenso non cambiano.
Gli ad blocker possono bloccare il server-side tracking?
Gli ad blocker possono bloccare il server-side tracking, ma è molto meno probabile: il browser invia i dati a un sottodominio del tuo sito, non ai domini dei fornitori che gli ad blocker tengono d’occhio, quindi le richieste sembrano traffico first-party. Qualche ad blocker blocca comunque un sottodominio di tracking quando ne individua la funzione: il server-side tracking riduce la perdita di dati, non la elimina.
Qual è un esempio di server-side tracking?
Un esempio classico di server-side tracking è la Meta Conversions API: invece di affidarsi solo al Meta Pixel nel browser, è un server a inviare gli eventi di conversione, come un acquisto, direttamente a Meta. Meta consiglia di usarla insieme al Pixel, con i due flussi deduplicati in modo che ogni acquisto sia conteggiato una volta sola.
Server-side tagging e server-side tracking sono la stessa cosa?
Server-side tagging e server-side tracking significano quasi la stessa cosa e quasi tutti usano i due termini come sinonimi. A rigore, il tagging descrive la configurazione: i container e i trigger che elaborano gli eventi. Il tracking descrive l’obiettivo: misurare azioni e conversioni degli utenti. Scegliere tra tagging server-side e client-side, quindi, è la stessa decisione che prendi su come tracciare.